Облачная архитектура десятилетиями оптимизировалась вокруг эффективности. Shared kernels, multi-tenant clusters, централизованные control planes, общая observability-инфраструктура и совместное использование ресурсов позволили сделать облачные платформы дешевле и проще в масштабировании.
Но модель угроз меняется. Сочетание всё более эффективных методов эксплуатации уязвимостей, автономных AI-агентов и тесно связанных между собой облачных компонентов делает shared primitives всё дороже с точки зрения риска.
Поэтому архитектурный вопрос постепенно меняется от «Сколько инфраструктуры мы можем безопасно разделять?» превращается в «Что должно оставаться изолированным даже в случае компрометации окружающей системы?» Так формируется новый подход — isolation-first architecture.
Почему ломается предположение о shared infrastructure
Традиционная облачная архитектура активно использует общую инфраструктуру. Упрощённо она выглядит так:
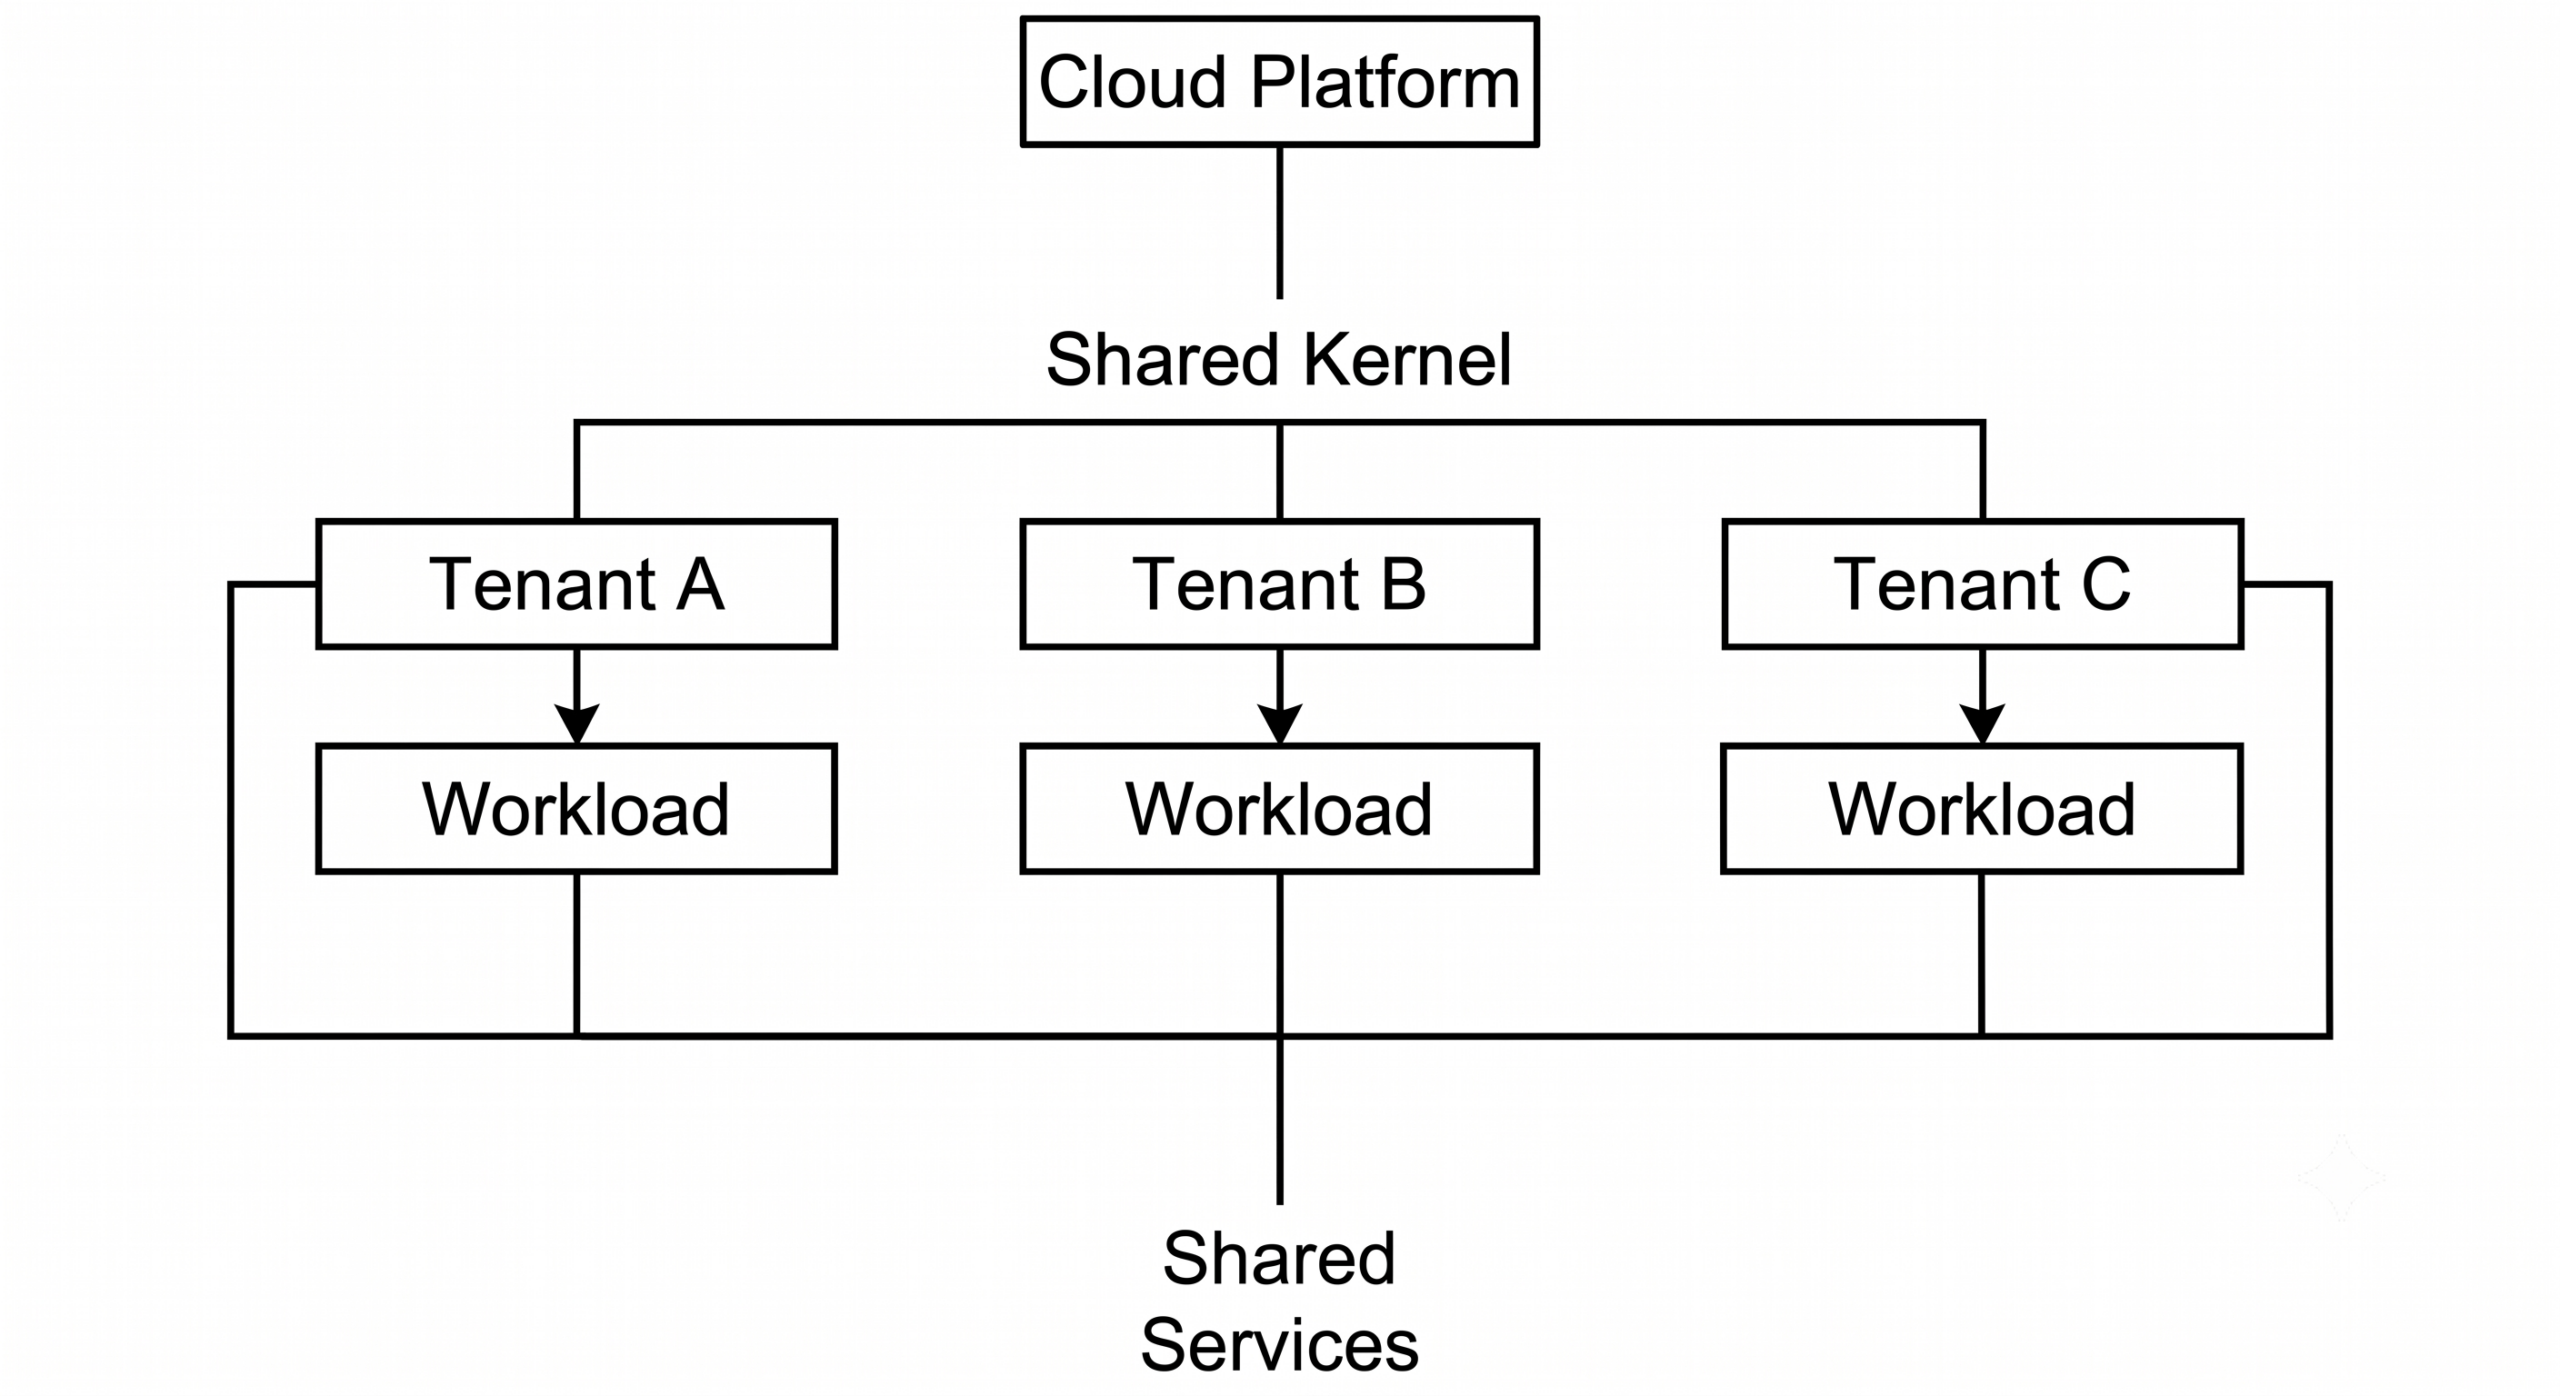
Такая модель эффективна. Она уменьшает дублирование инфраструктуры, повышает утилизацию ресурсов и делает крупные платформы экономически оправданными. Но одновременно она создаёт общие failure domains — домены отказа. Если уязвимость или ошибка конфигурации затрагивает shared primitive, последствия могут выйти далеко за пределы исходного workload.
Уязвимость ядра — это не обязательно проблема одного контейнера. Сбой DNS — не обязательно проблема одного сервиса. Отказ control plane — не обязательно проблема одного tenant. Общая характеристика здесь одна: blast radius — радиус распространения последствий.
Новый архитектурный вопрос: насколько далеко распространяется отказ?
Традиционная security architecture в первую очередь стремилась предотвратить компрометацию. Современная облачная архитектура всё чаще должна исходить из другого предположения:
Некоторые компрометации всё равно произойдут.
Поэтому вопрос меняется. Теперь важно понимать:
Если этот компонент будет скомпрометирован, насколько далеко распространится отказ?
Это переводит архитектуру от perimeter-oriented security к failure containment — локализации последствий отказа или компрометации.
Вместо простой модели: trusted → untrusted
появляется: isolated → independently compromised → contained
Архитектура начинает выглядеть так:
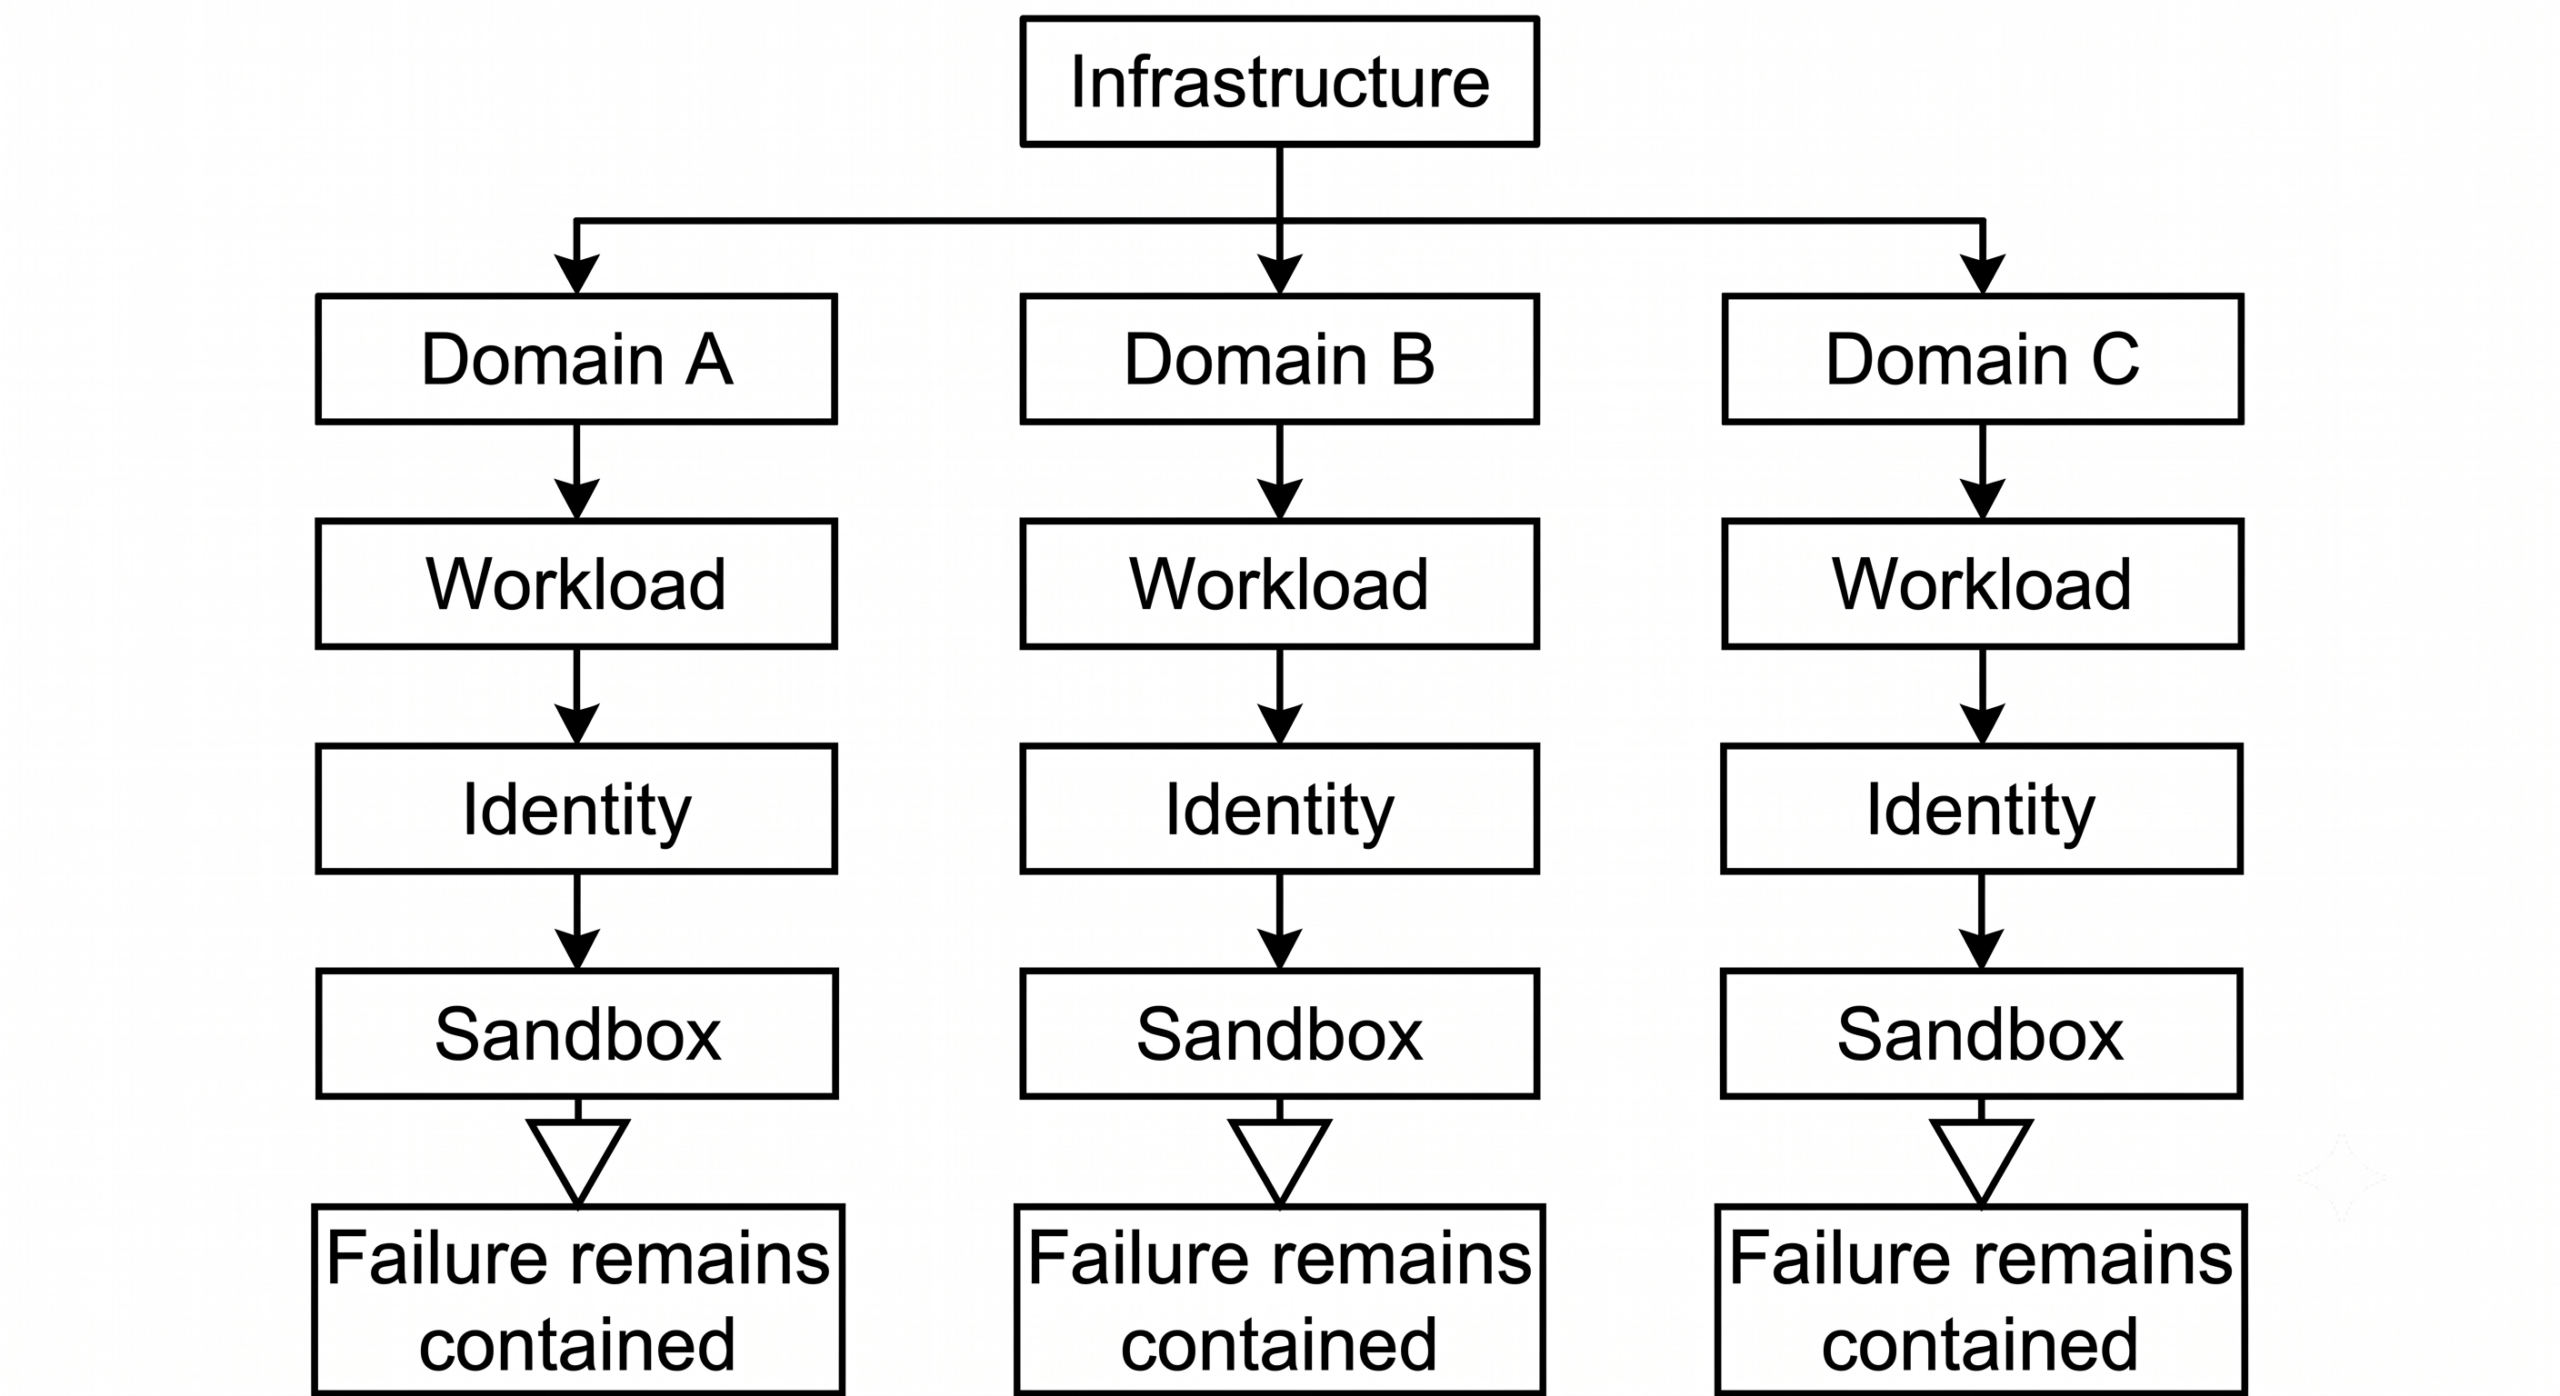
Цель больше не заключается в том, чтобы гарантировать отсутствие отказов. Цель — не позволить одному отказу превратиться в отказ всей системы.
Почему AI меняет модель угроз
Этот сдвиг был бы важен и без AI. Но AI меняет скорость и экономику эксплуатации уязвимостей. Современные AI-системы способны ускорять отдельные этапы поиска, анализа и эксплуатации уязвимостей. Одновременно agentic systems вводят автономные компоненты, которые могут работать с инфраструктурой, API, файлами и credentials.
В результате возникает принципиально другая проблема безопасности. Обычный сервис обычно выполняет заранее определённый набор операций. Автономный агент может динамически решать:
- какой tool вызвать;
- какой API использовать;
- к какому ресурсу обратиться;
- повторять ли операцию;
- делегировать ли задачу;
- какое действие выполнить следующим.
Поэтому архитектура должна ограничивать не только какой код может выполняться, но и к каким ресурсам автономный workload может получить доступ. Новая модель выглядит так:
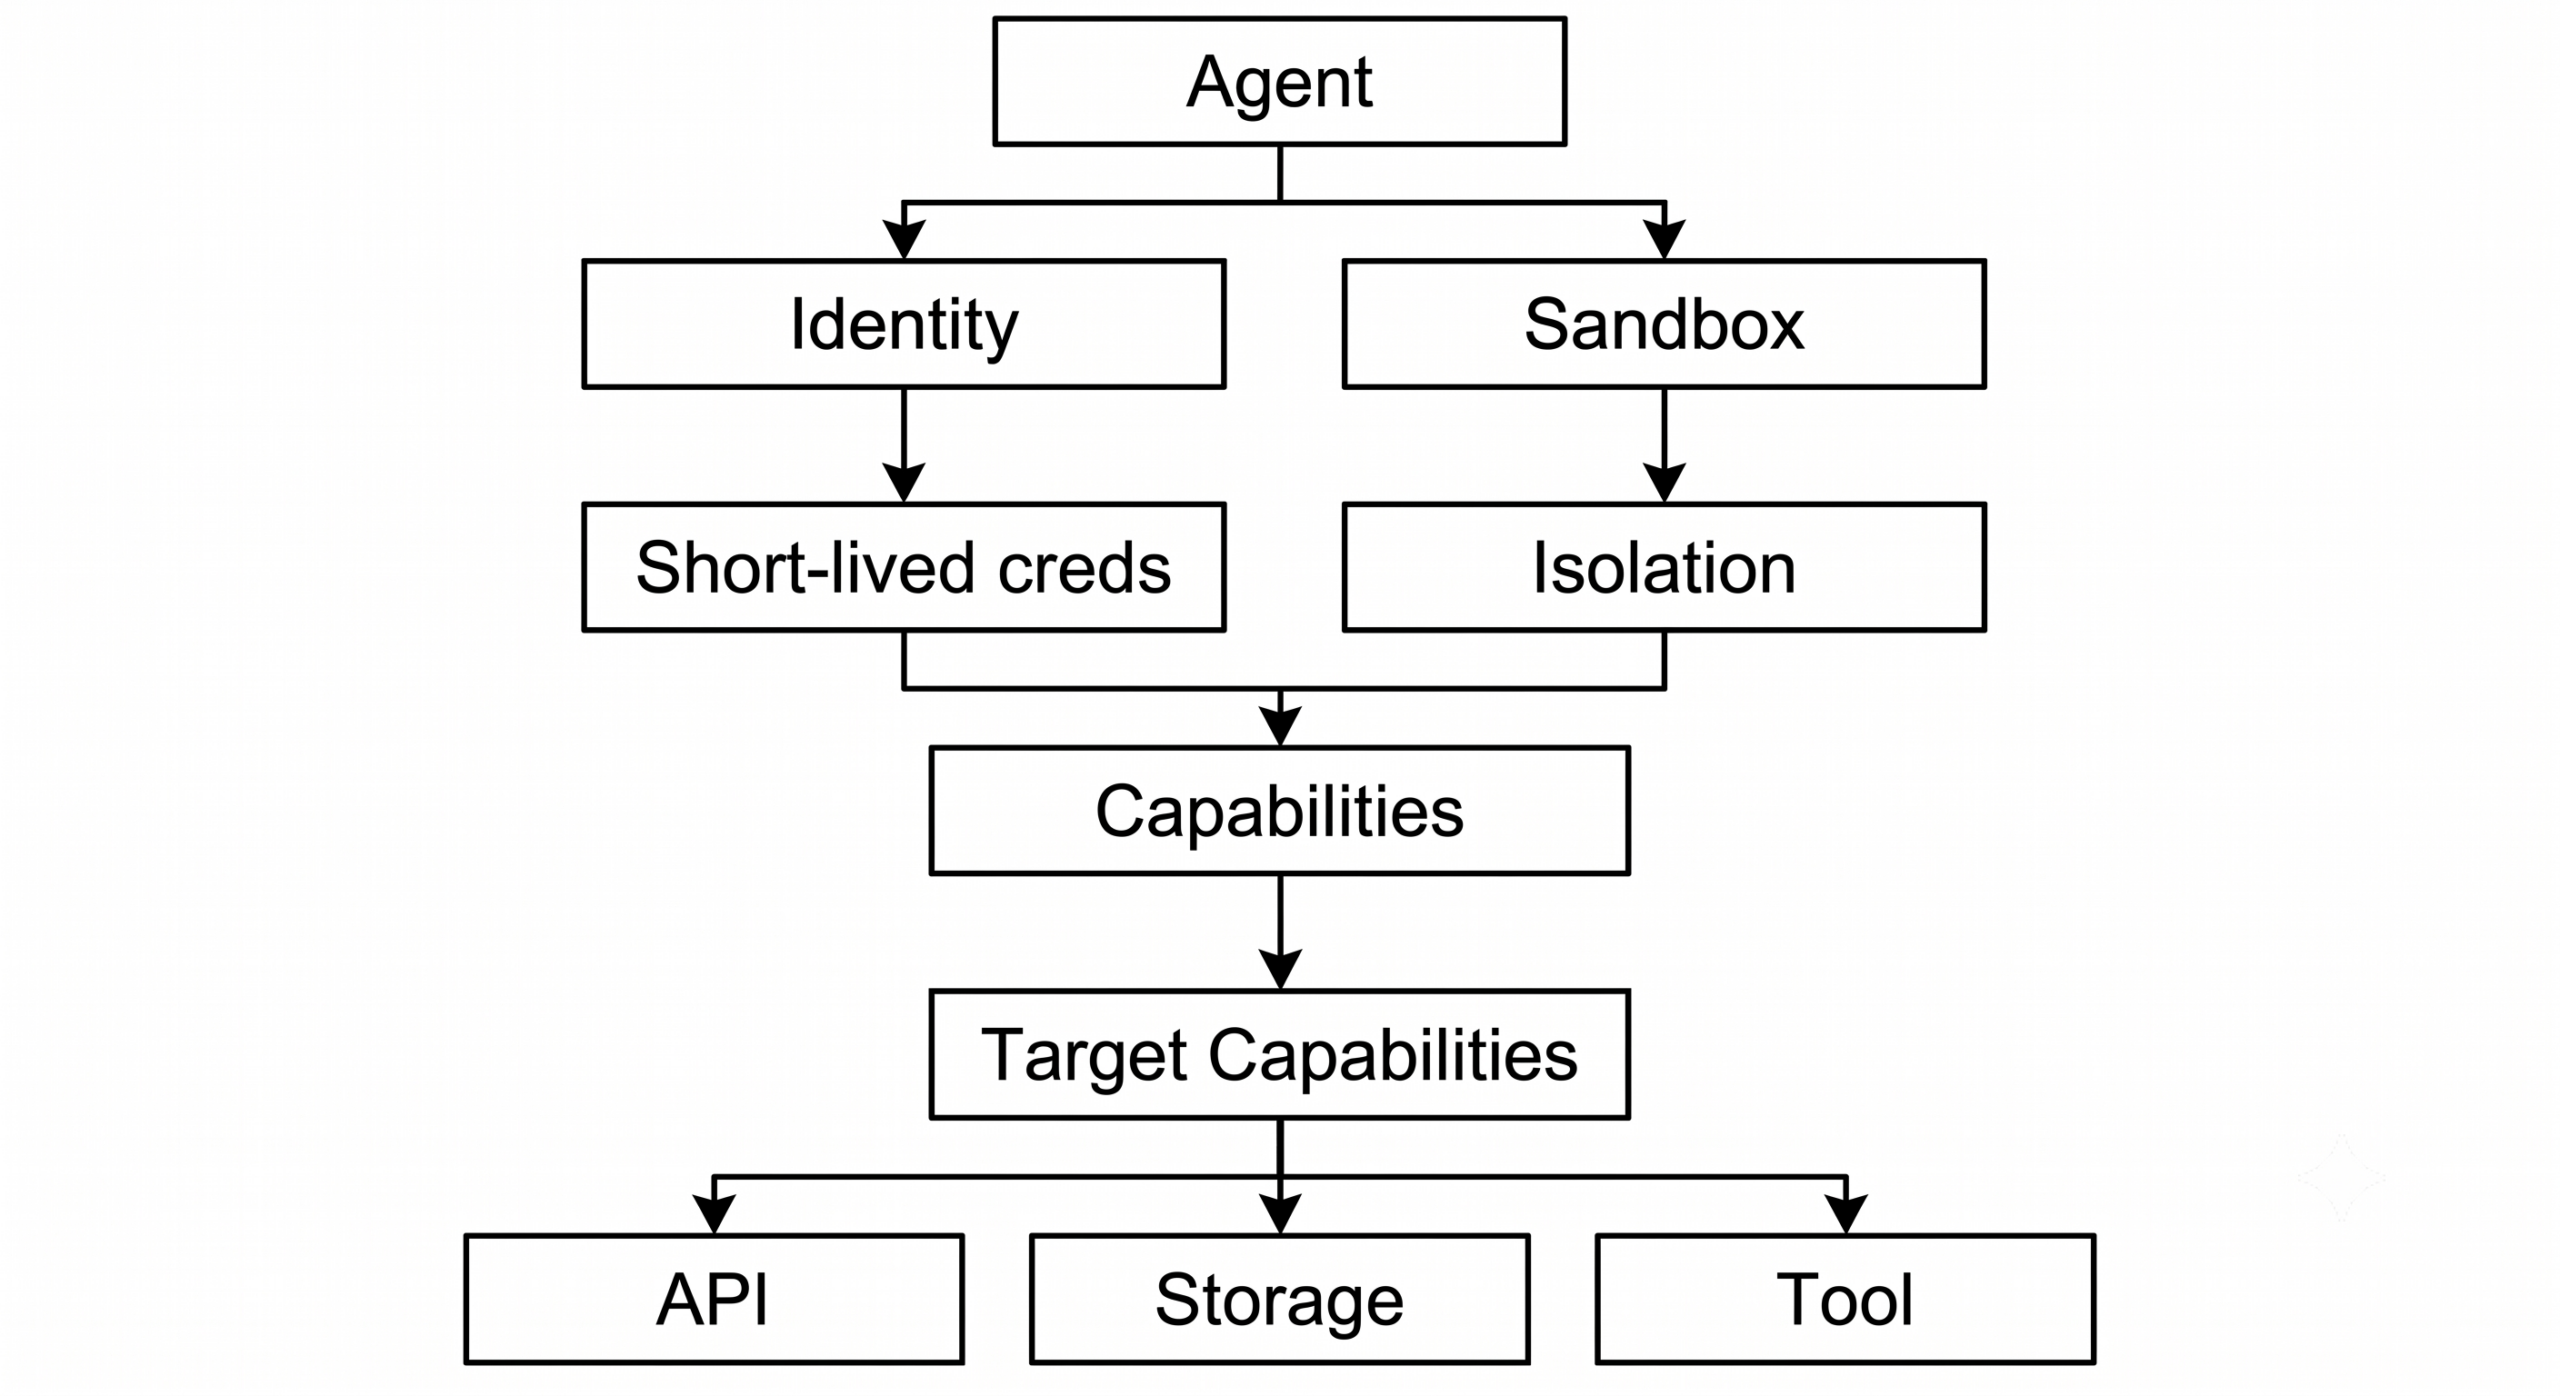
Таким образом, identity и execution boundary становятся тесно связанными.
Изоляция опускается вниз по стеку
Ответ инфраструктурной индустрии становится заметен на разных уровнях. Речь идёт уже не только об изоляции приложения от внешнего мира. Изоляция появляется внутри самой платформы. Разные технологии реализуют разные варианты этого подхода:
- Confidential Containers;
- Kata Containers;
- gVisor;
- MicroVM-based execution;
- sandboxed Kubernetes workloads;
- hardware-backed roots of trust;
- sealed operating-system images;
- workload identities, такие как SPIFFE.
У них разные задачи, но архитектурное направление одно: уменьшить количество инфраструктуры, которой необходимо доверять. Упрощённая модель trust hierarchy:
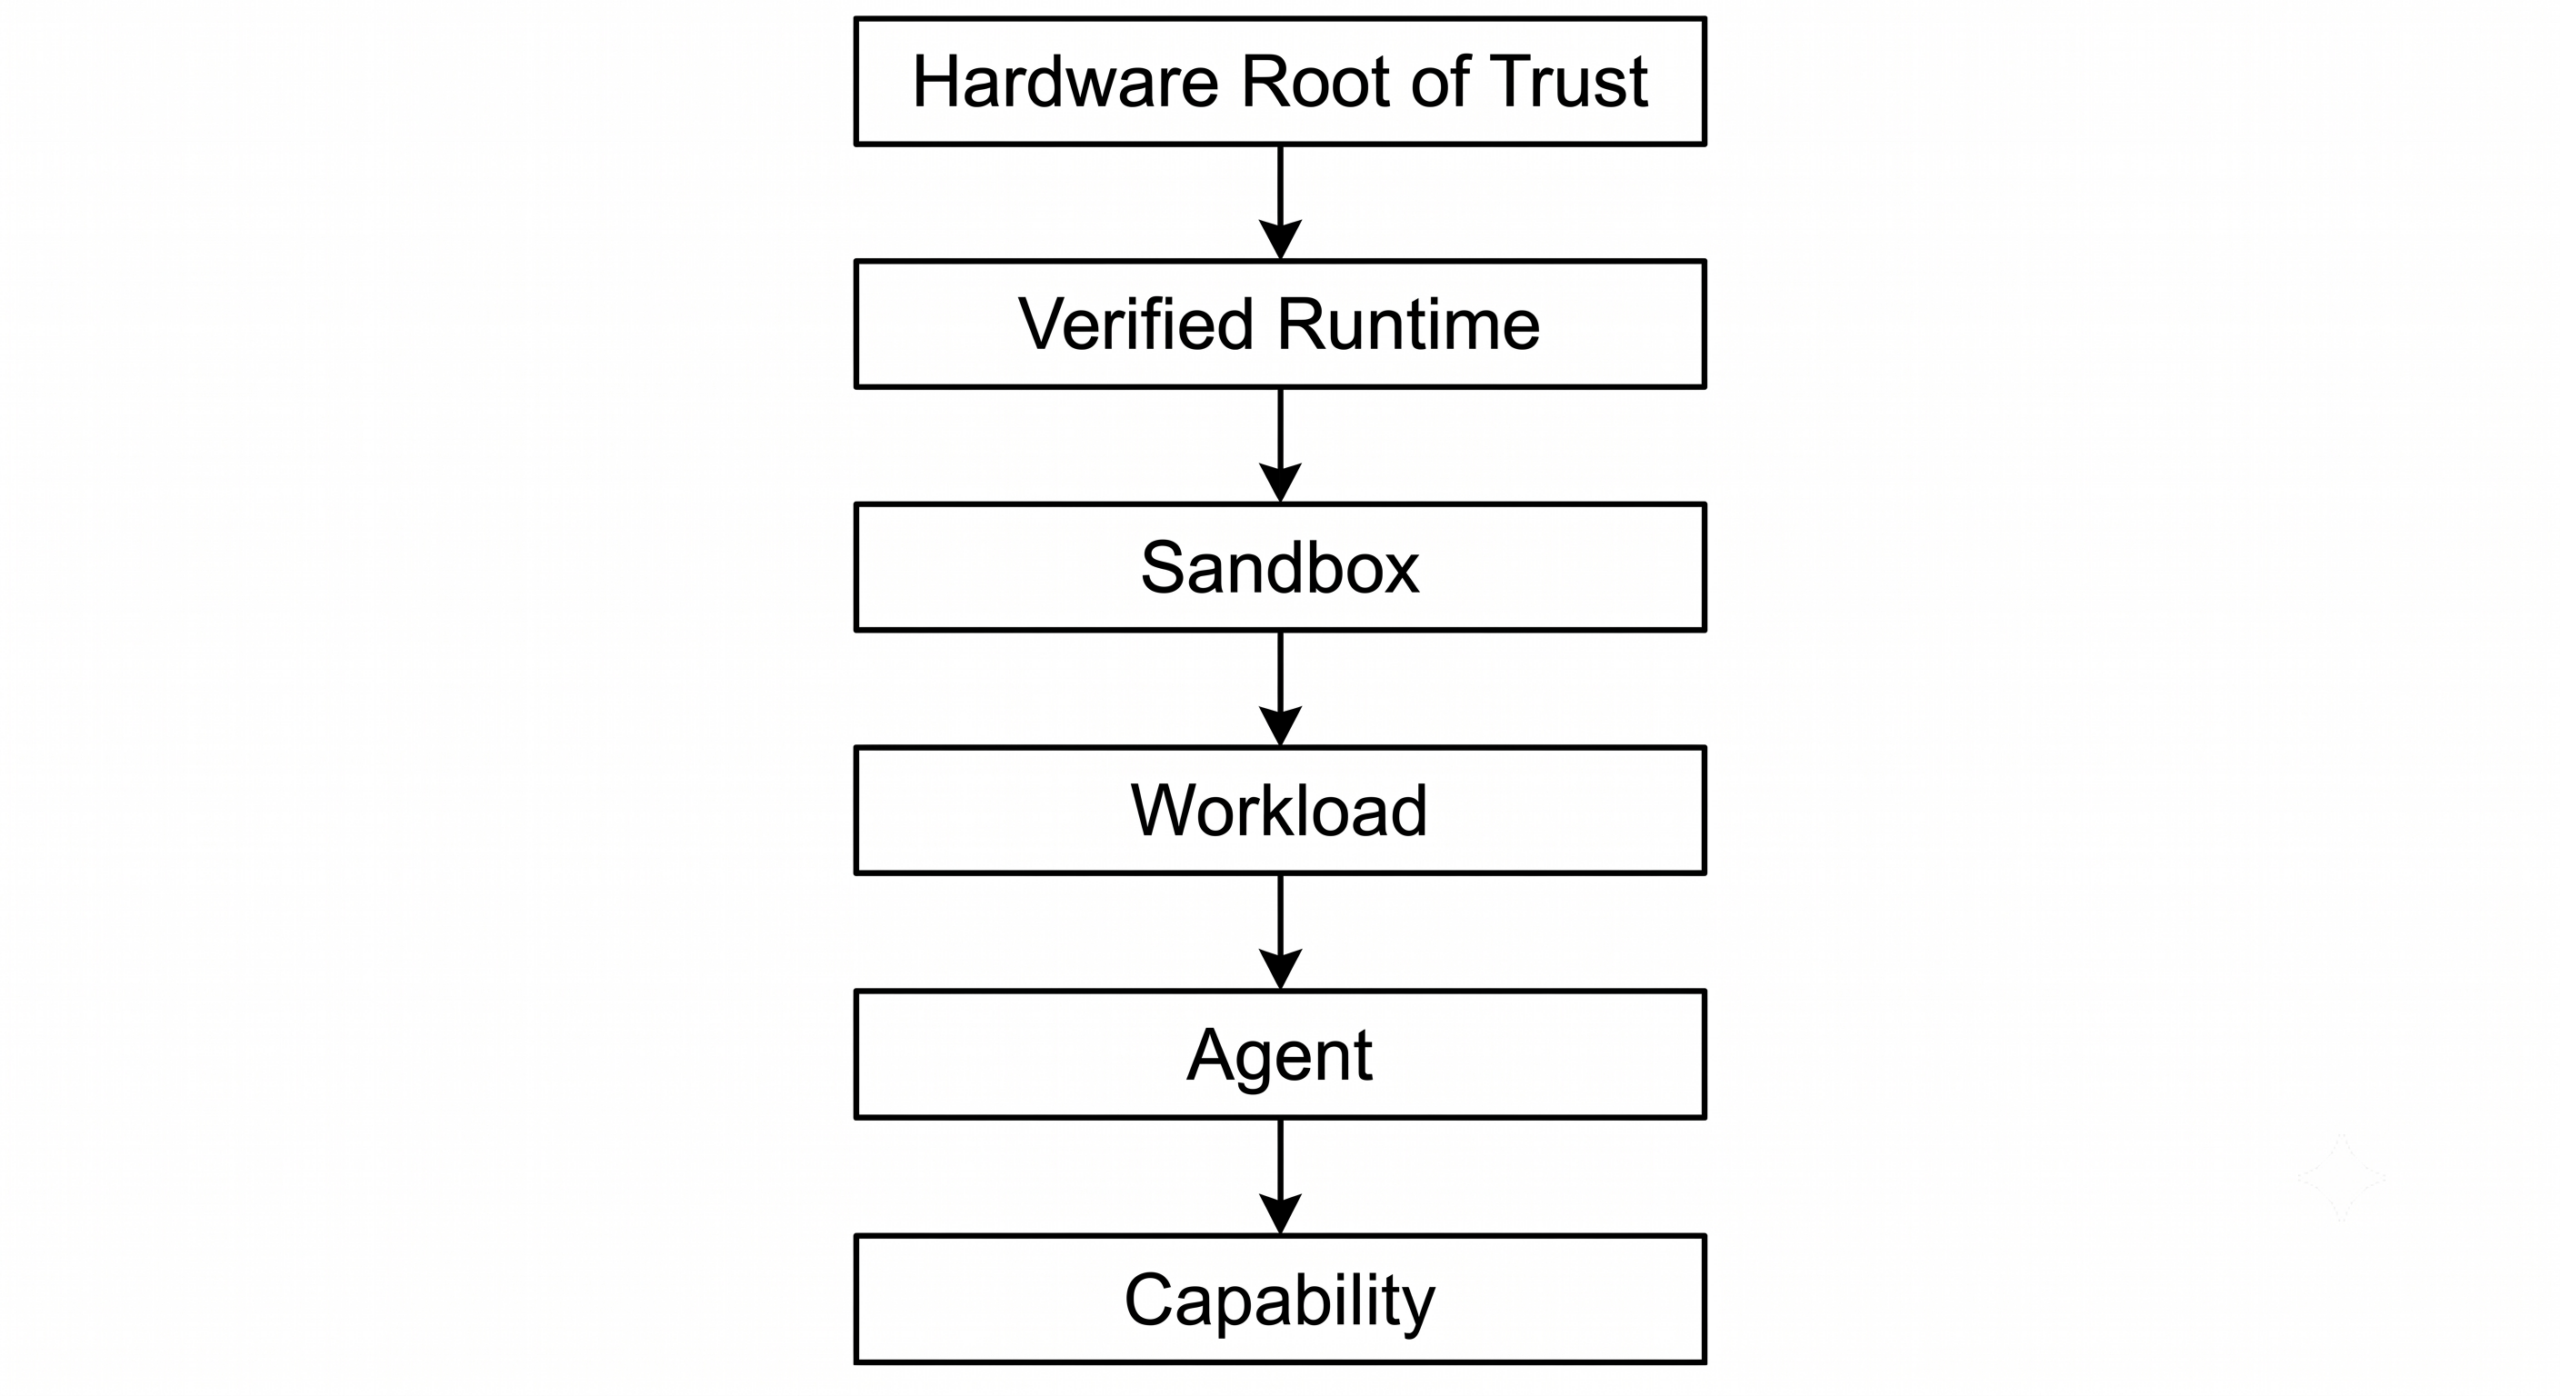
Чем глубже находится граница изоляции, тем меньше потенциальный blast radius.
Kubernetes становится более granular
Kubernetes изначально сделал возможной эффективную эксплуатацию большого количества workloads на общей инфраструктуре. Эта модель остаётся фундаментальной. Но по мере роста автономности workloads и требований к безопасности Kubernetes получает всё более granular механизмы управления изоляцией и ресурсными границами. Это включает:
- более строгие admission policies;
- контроль ресурсов на уровне workload;
- device-aware resource allocation;
- sandboxed execution;
- более жёсткие networking boundaries;
- уменьшение зависимости от неоднозначных shared primitives.
Важно не то, что Kubernetes отказывается от multi-tenancy. Сдвиг заключается в другом: multi-tenancy всё чаще требует явно определённых гарантий изоляции.
Платформа движется от: shared by default
к: shared only where the trust boundary allows it.
Identity должна следовать за workload
Традиционная cloud security часто предполагает, что расположение в сети имеет значение. Если workload находится внутри кластера, ему доступны определённые внутренние сервисы. Если он принадлежит определённой subnet, он получает определённые права. По мере усложнения архитектур эта модель становится слабее. Более устойчивый подход:
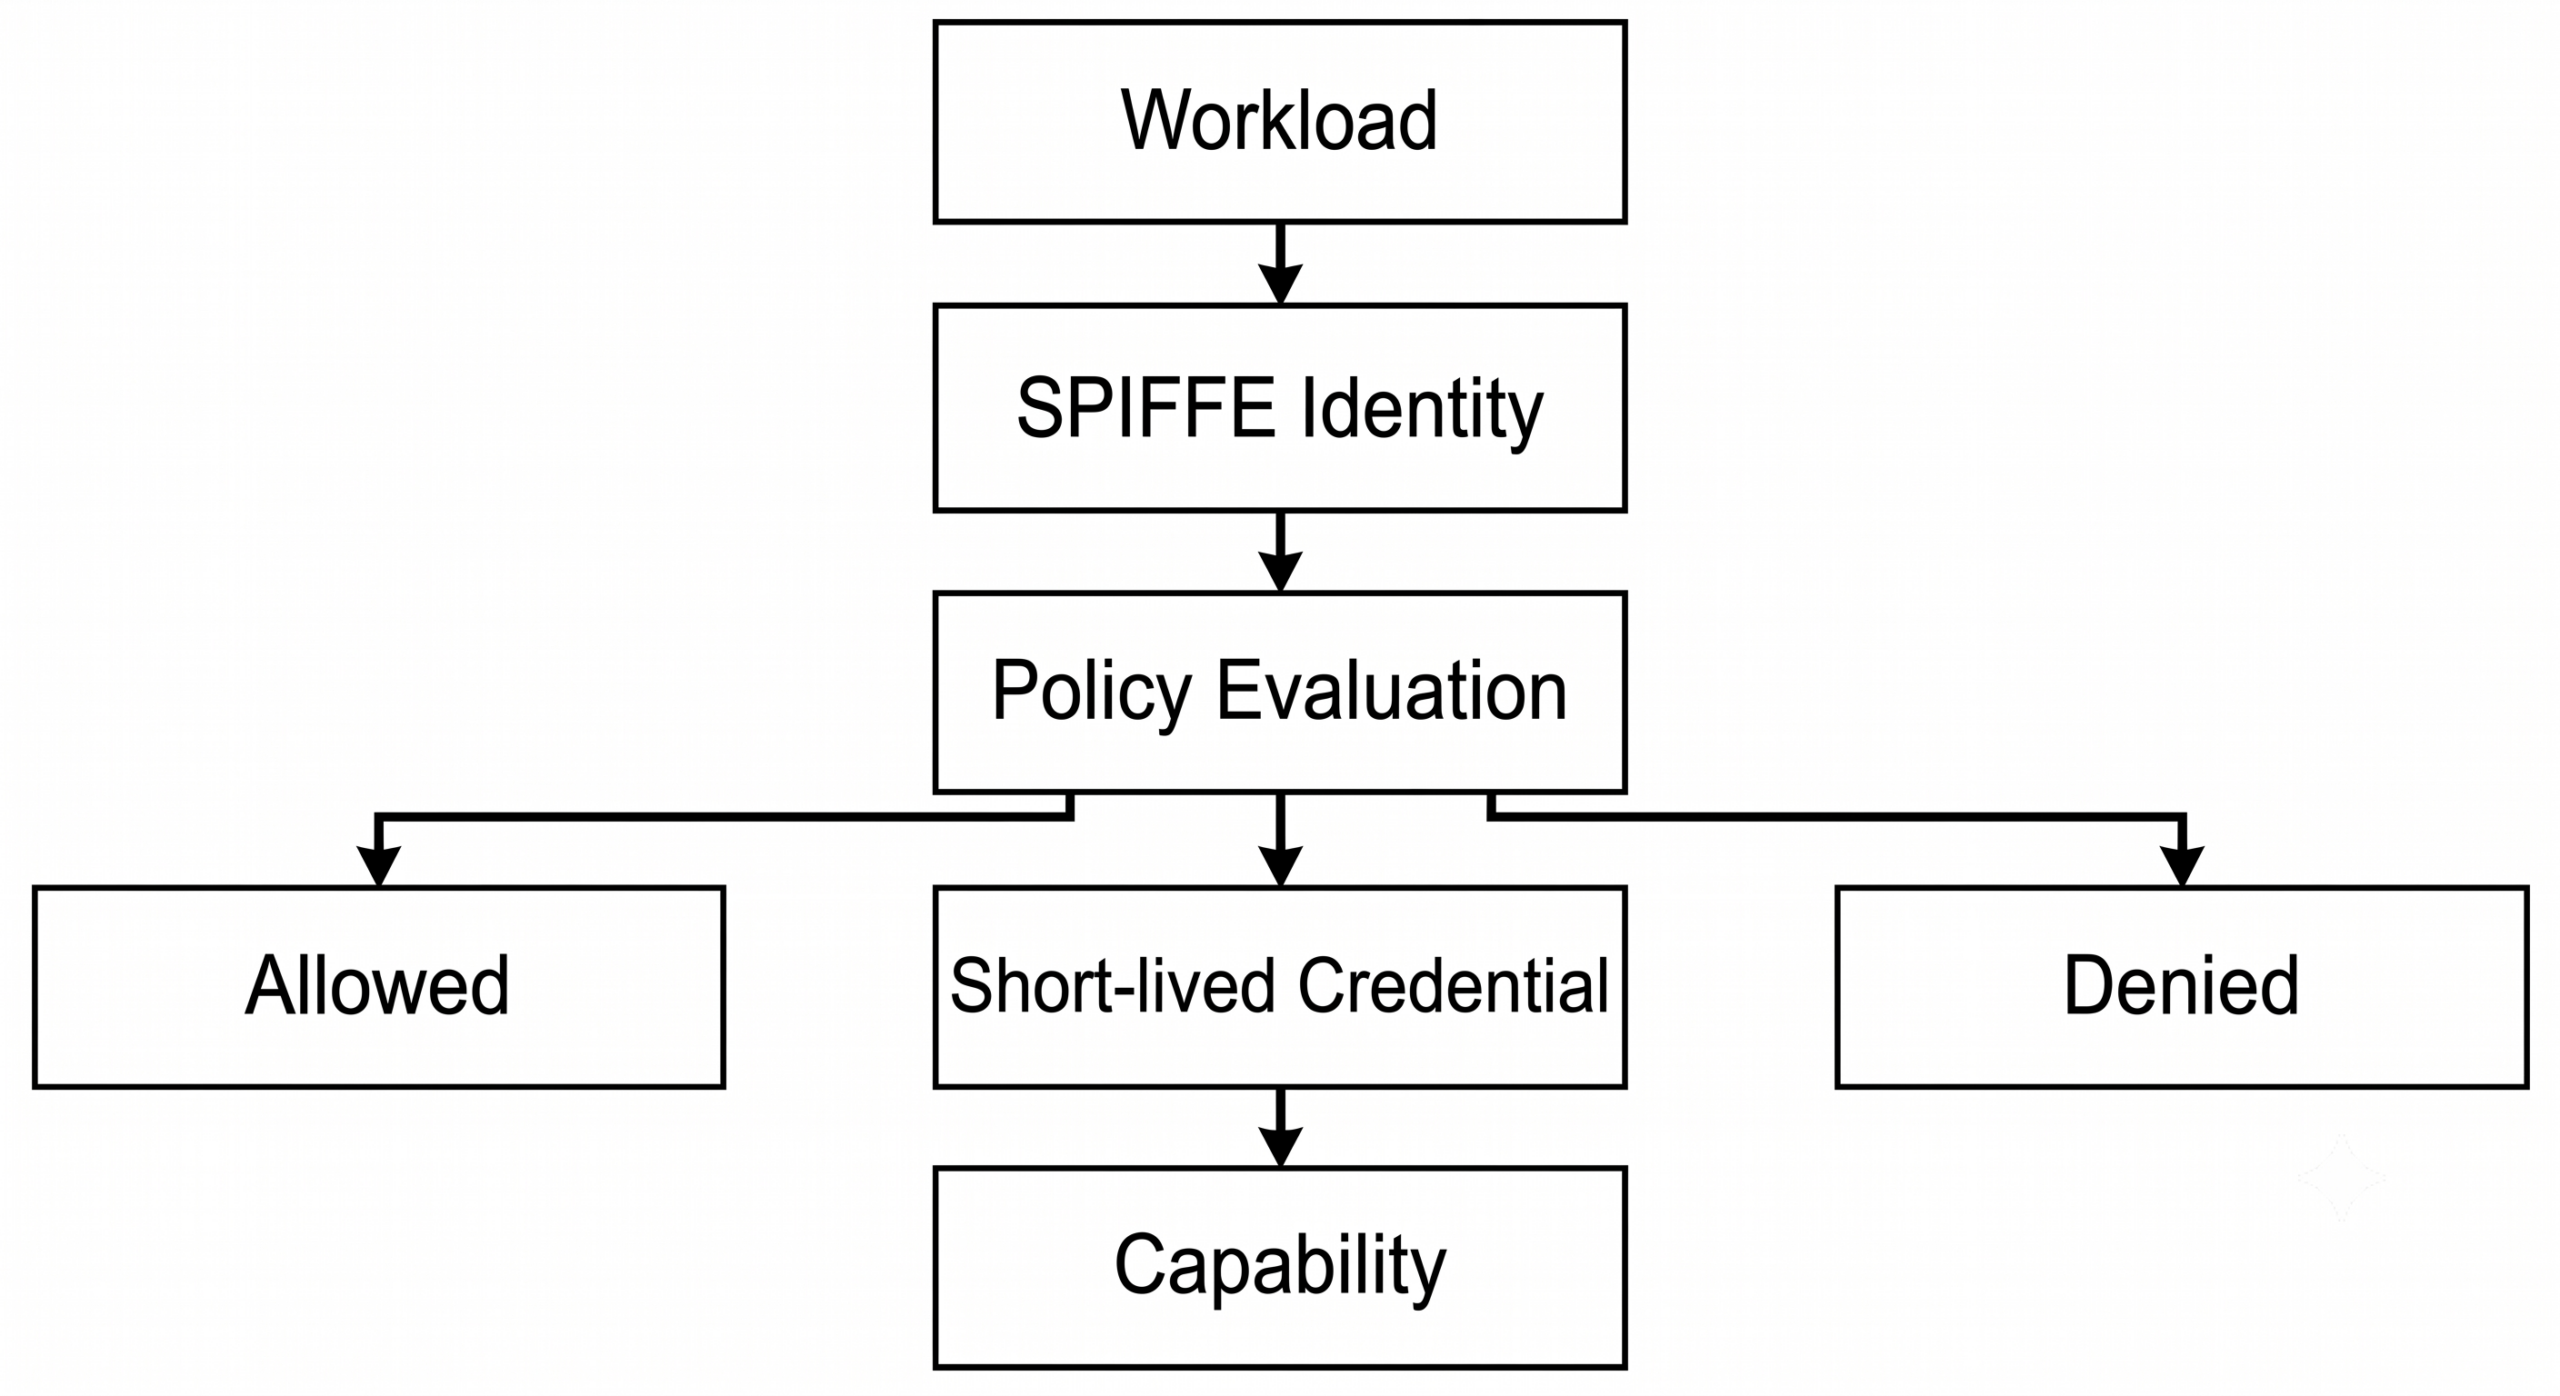
Identity привязывается к workload, а не к его сетевому расположению. Особенно важно это для автономных агентов. Агент не должен получать широкие cloud credentials только потому, что он работает внутри доверенного кластера. Предпочтительная цепочка выглядит так:
identity → policy → short-lived credential → scoped capability
От shared control planes к нескольким failure domains
Изоляция касается не только workloads. Тот же принцип распространяется на инфраструктуру самой платформы. Observability, IAM, deployment systems, networking и control planes могут сами становиться источниками коррелированных отказов.
Если всё зависит от одного shared control plane, система может обладать высокой доступностью отдельных компонентов, но при этом иметь огромный systemic blast radius. Более устойчивая архитектура разделяет критические домены:
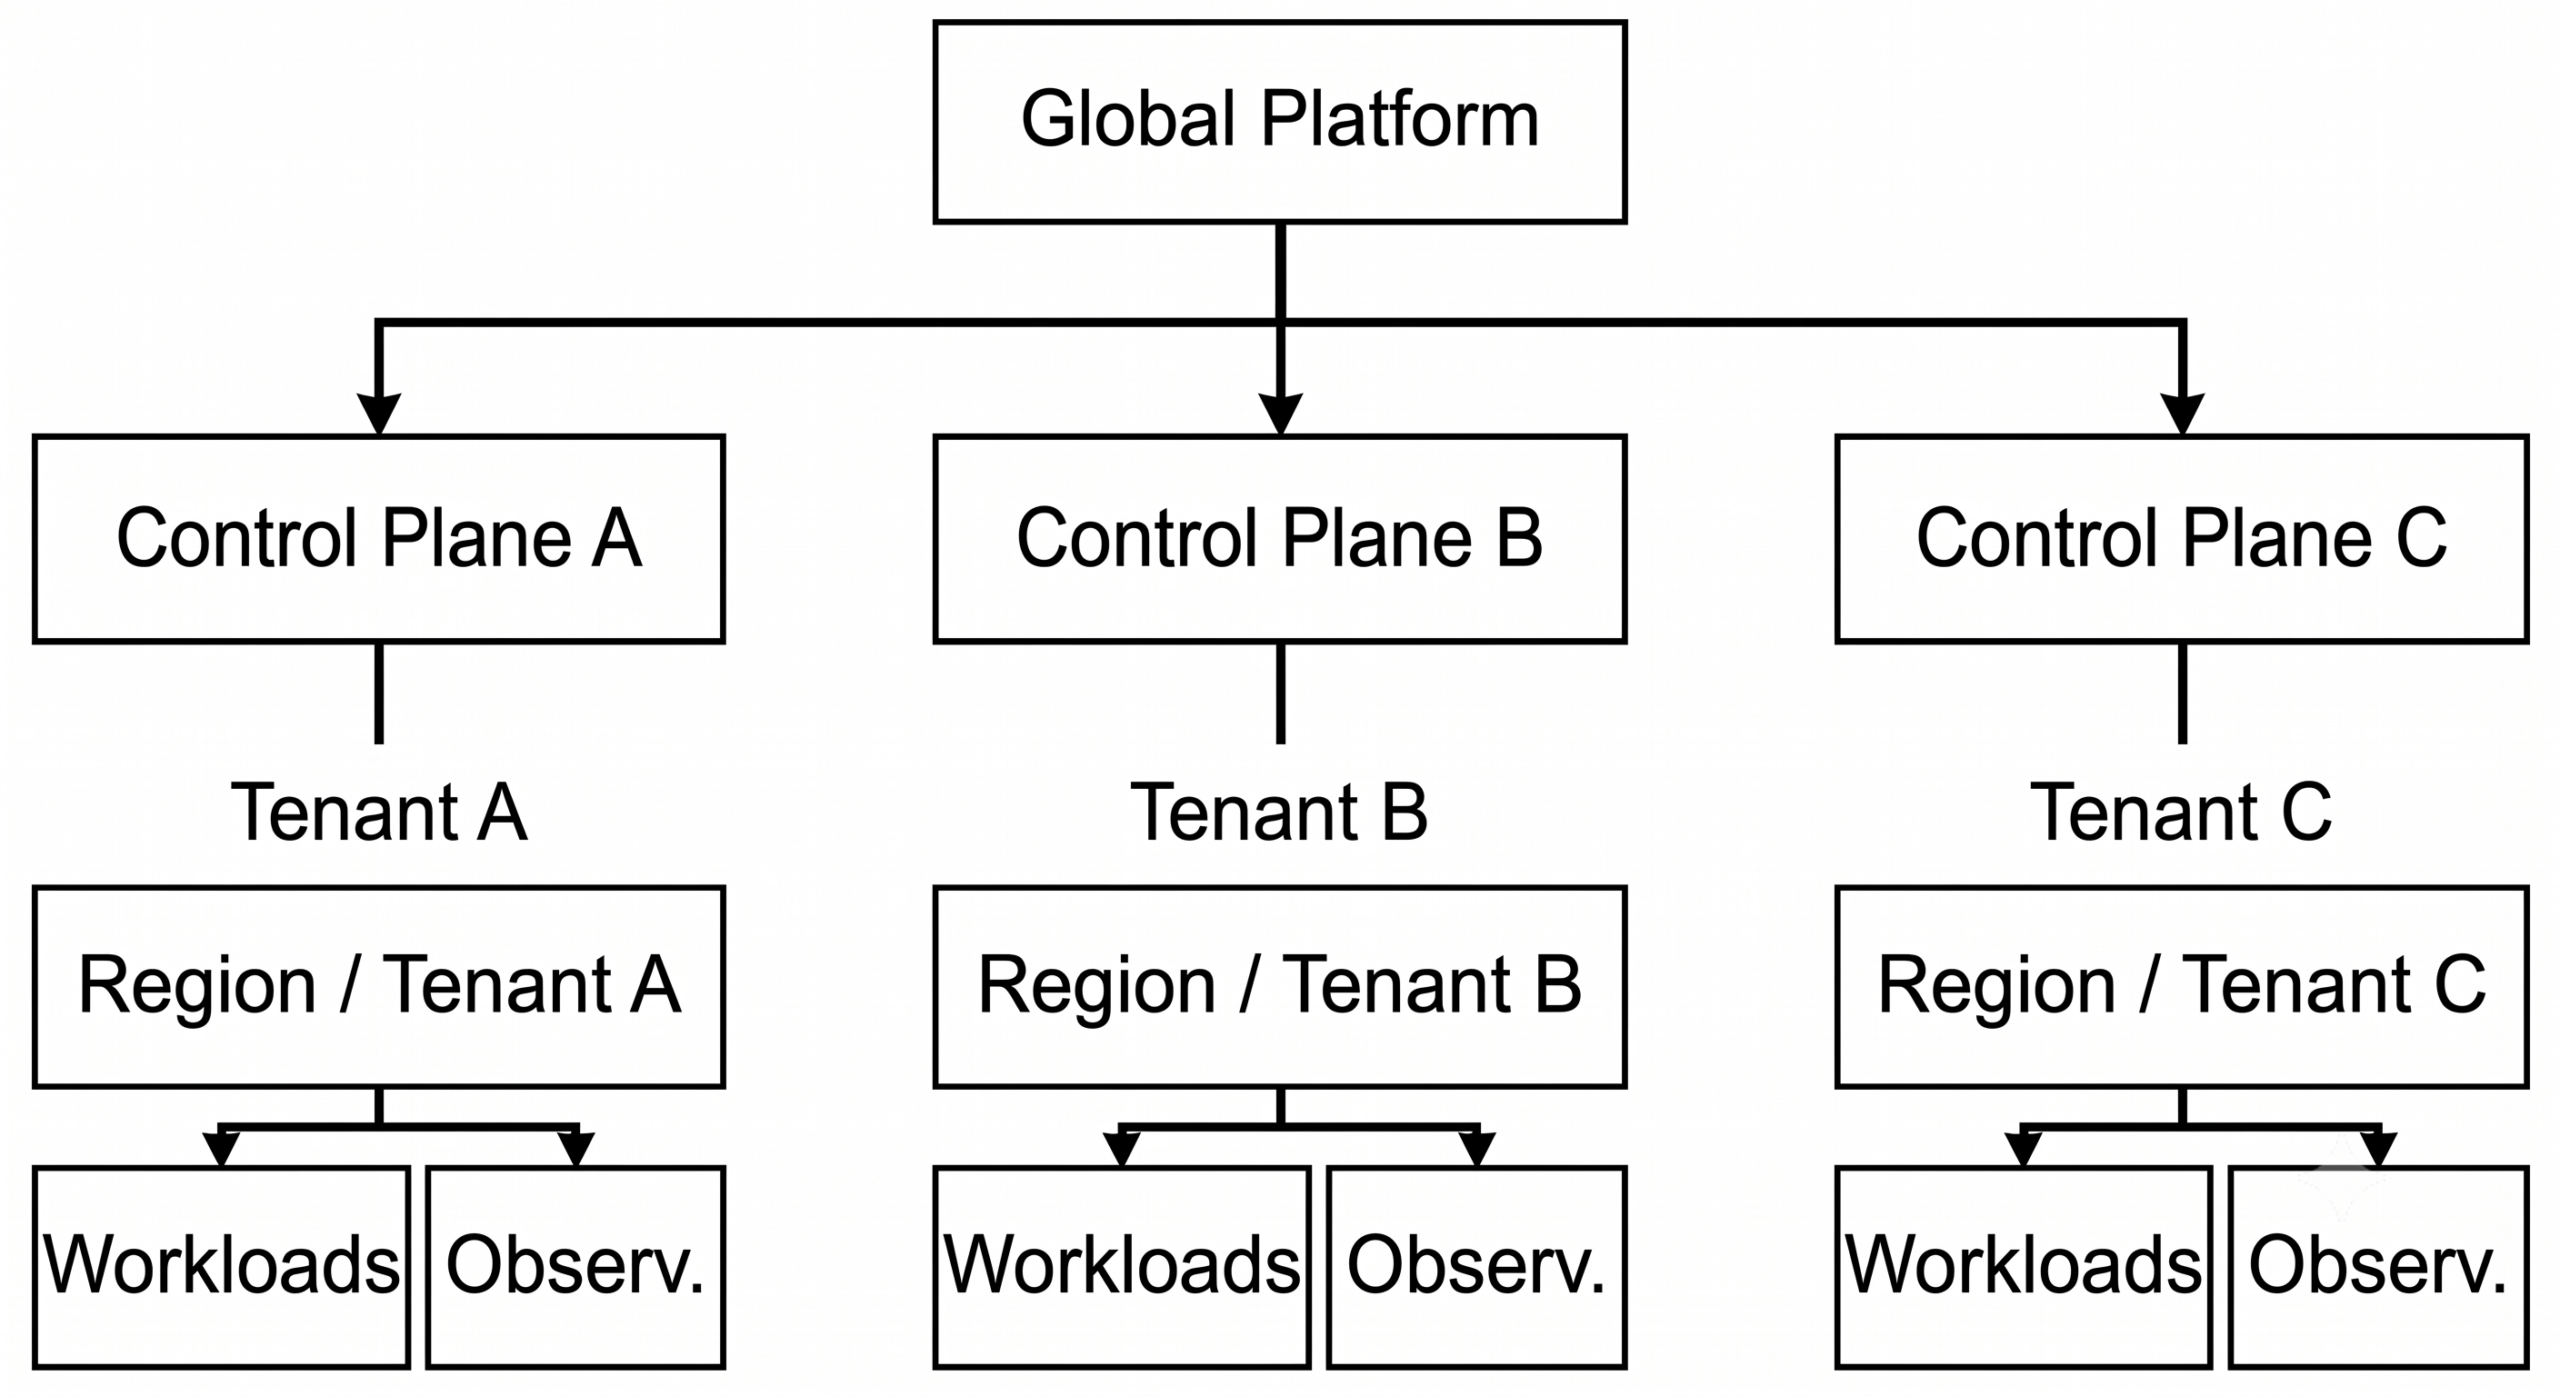
Цель не в полной независимости. Цель — containment of failure, то есть локализация последствий. Если один домен выходит из строя, критические системы за его пределами должны продолжать работать.
Observability тоже требует изоляции
Observability-инфраструктура часто воспринимается как пассивный компонент. На практике она сама может стать частью failure domain. Shared observability cluster может принимать telemetry от тысяч workloads. Ошибка конфигурации, перегрузка или security incident поэтому способны одновременно затронуть мониторинг и системы, которые он должен мониторить. Возникает архитектурный парадокс:
Система, которая должна обнаруживать отказ, сама может стать частью этого отказа.
Ответ — изолировать критические observability paths. Это может включать:
- отдельные observability clusters;
- отдельные credentials;
- независимое storage;
- изолированные network paths;
- строгие resource quotas;
- отдельные operational domains.
Принцип простой:
Критические системы не должны зависеть от того же failure domain, который они должны диагностировать.
Multi-tenancy не исчезает — она становится более селективной
Multi-tenancy остаётся одним из важнейших экономических механизмов cloud computing. Полная изоляция каждого tenant увеличила бы инфраструктурные расходы и операционную сложность. Поэтому наиболее вероятный сценарий — не переход от:
shared infrastructure → completely isolated infrastructure
а к модели:
shared control plane + isolated execution
где наиболее чувствительные workloads получают более сильные границы.
Например:
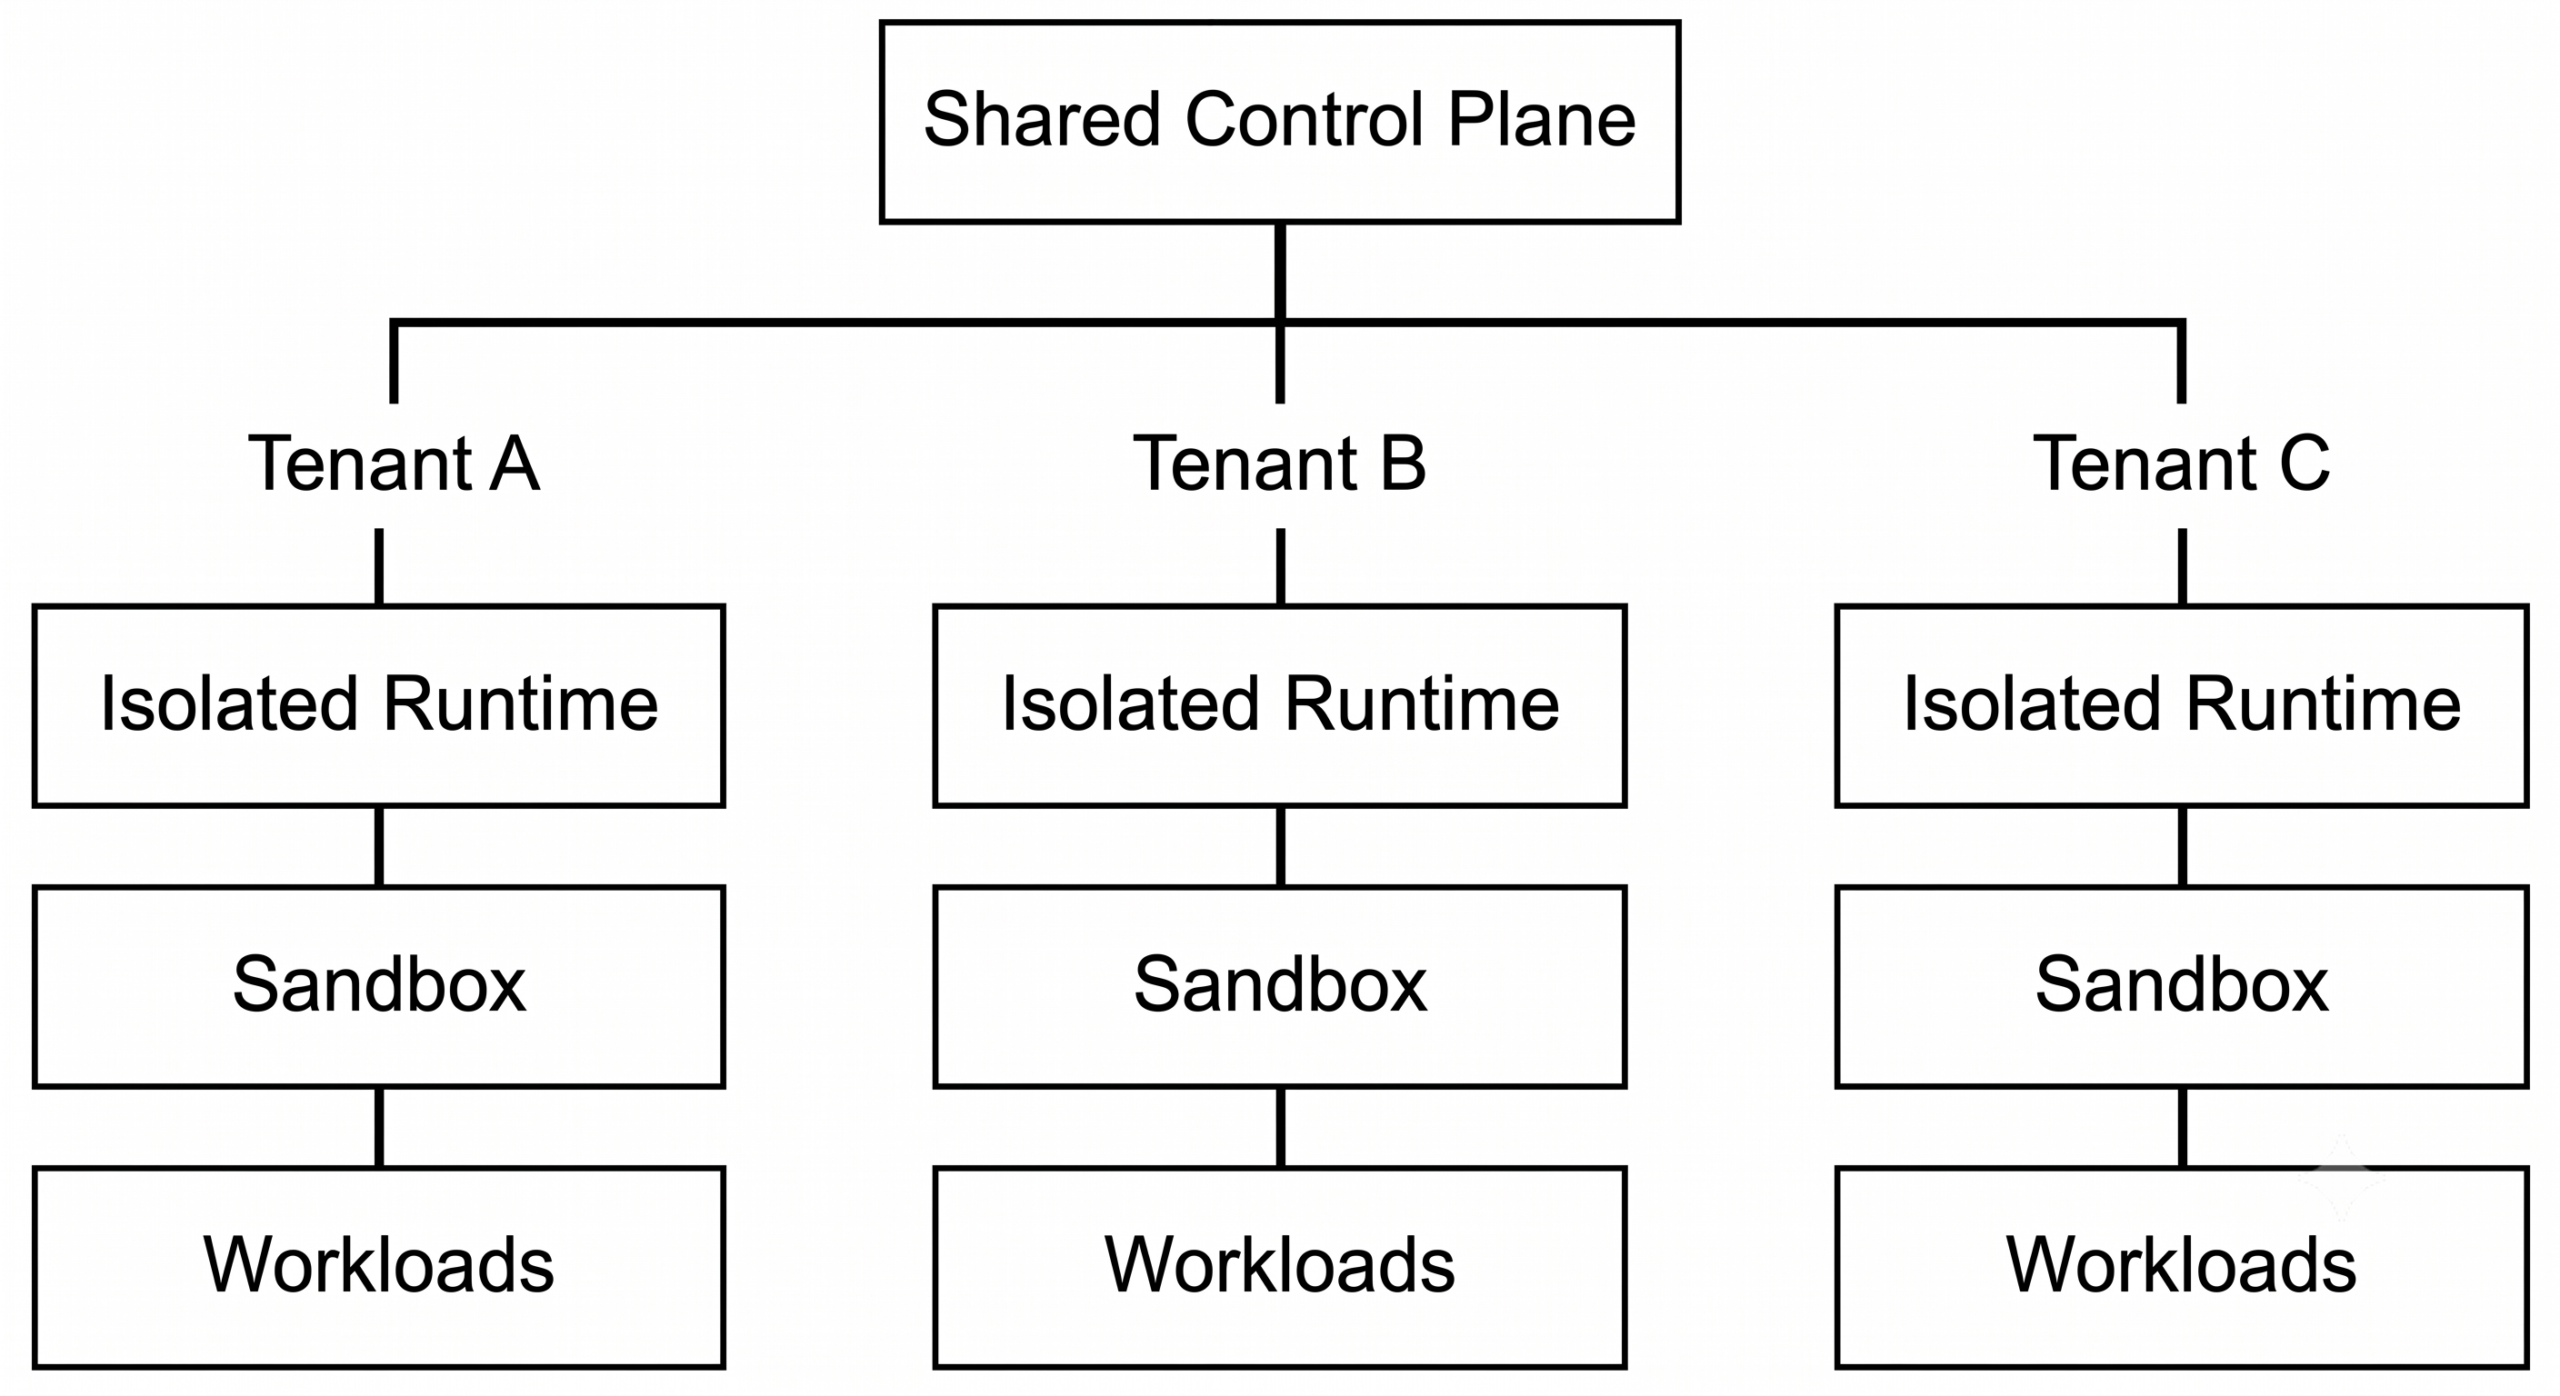
Так платформа сохраняет часть экономических преимуществ shared infrastructure, одновременно уменьшая blast radius отдельных workloads.
От security perimeter к isolation boundary
Более широкий архитектурный переход можно представить так:
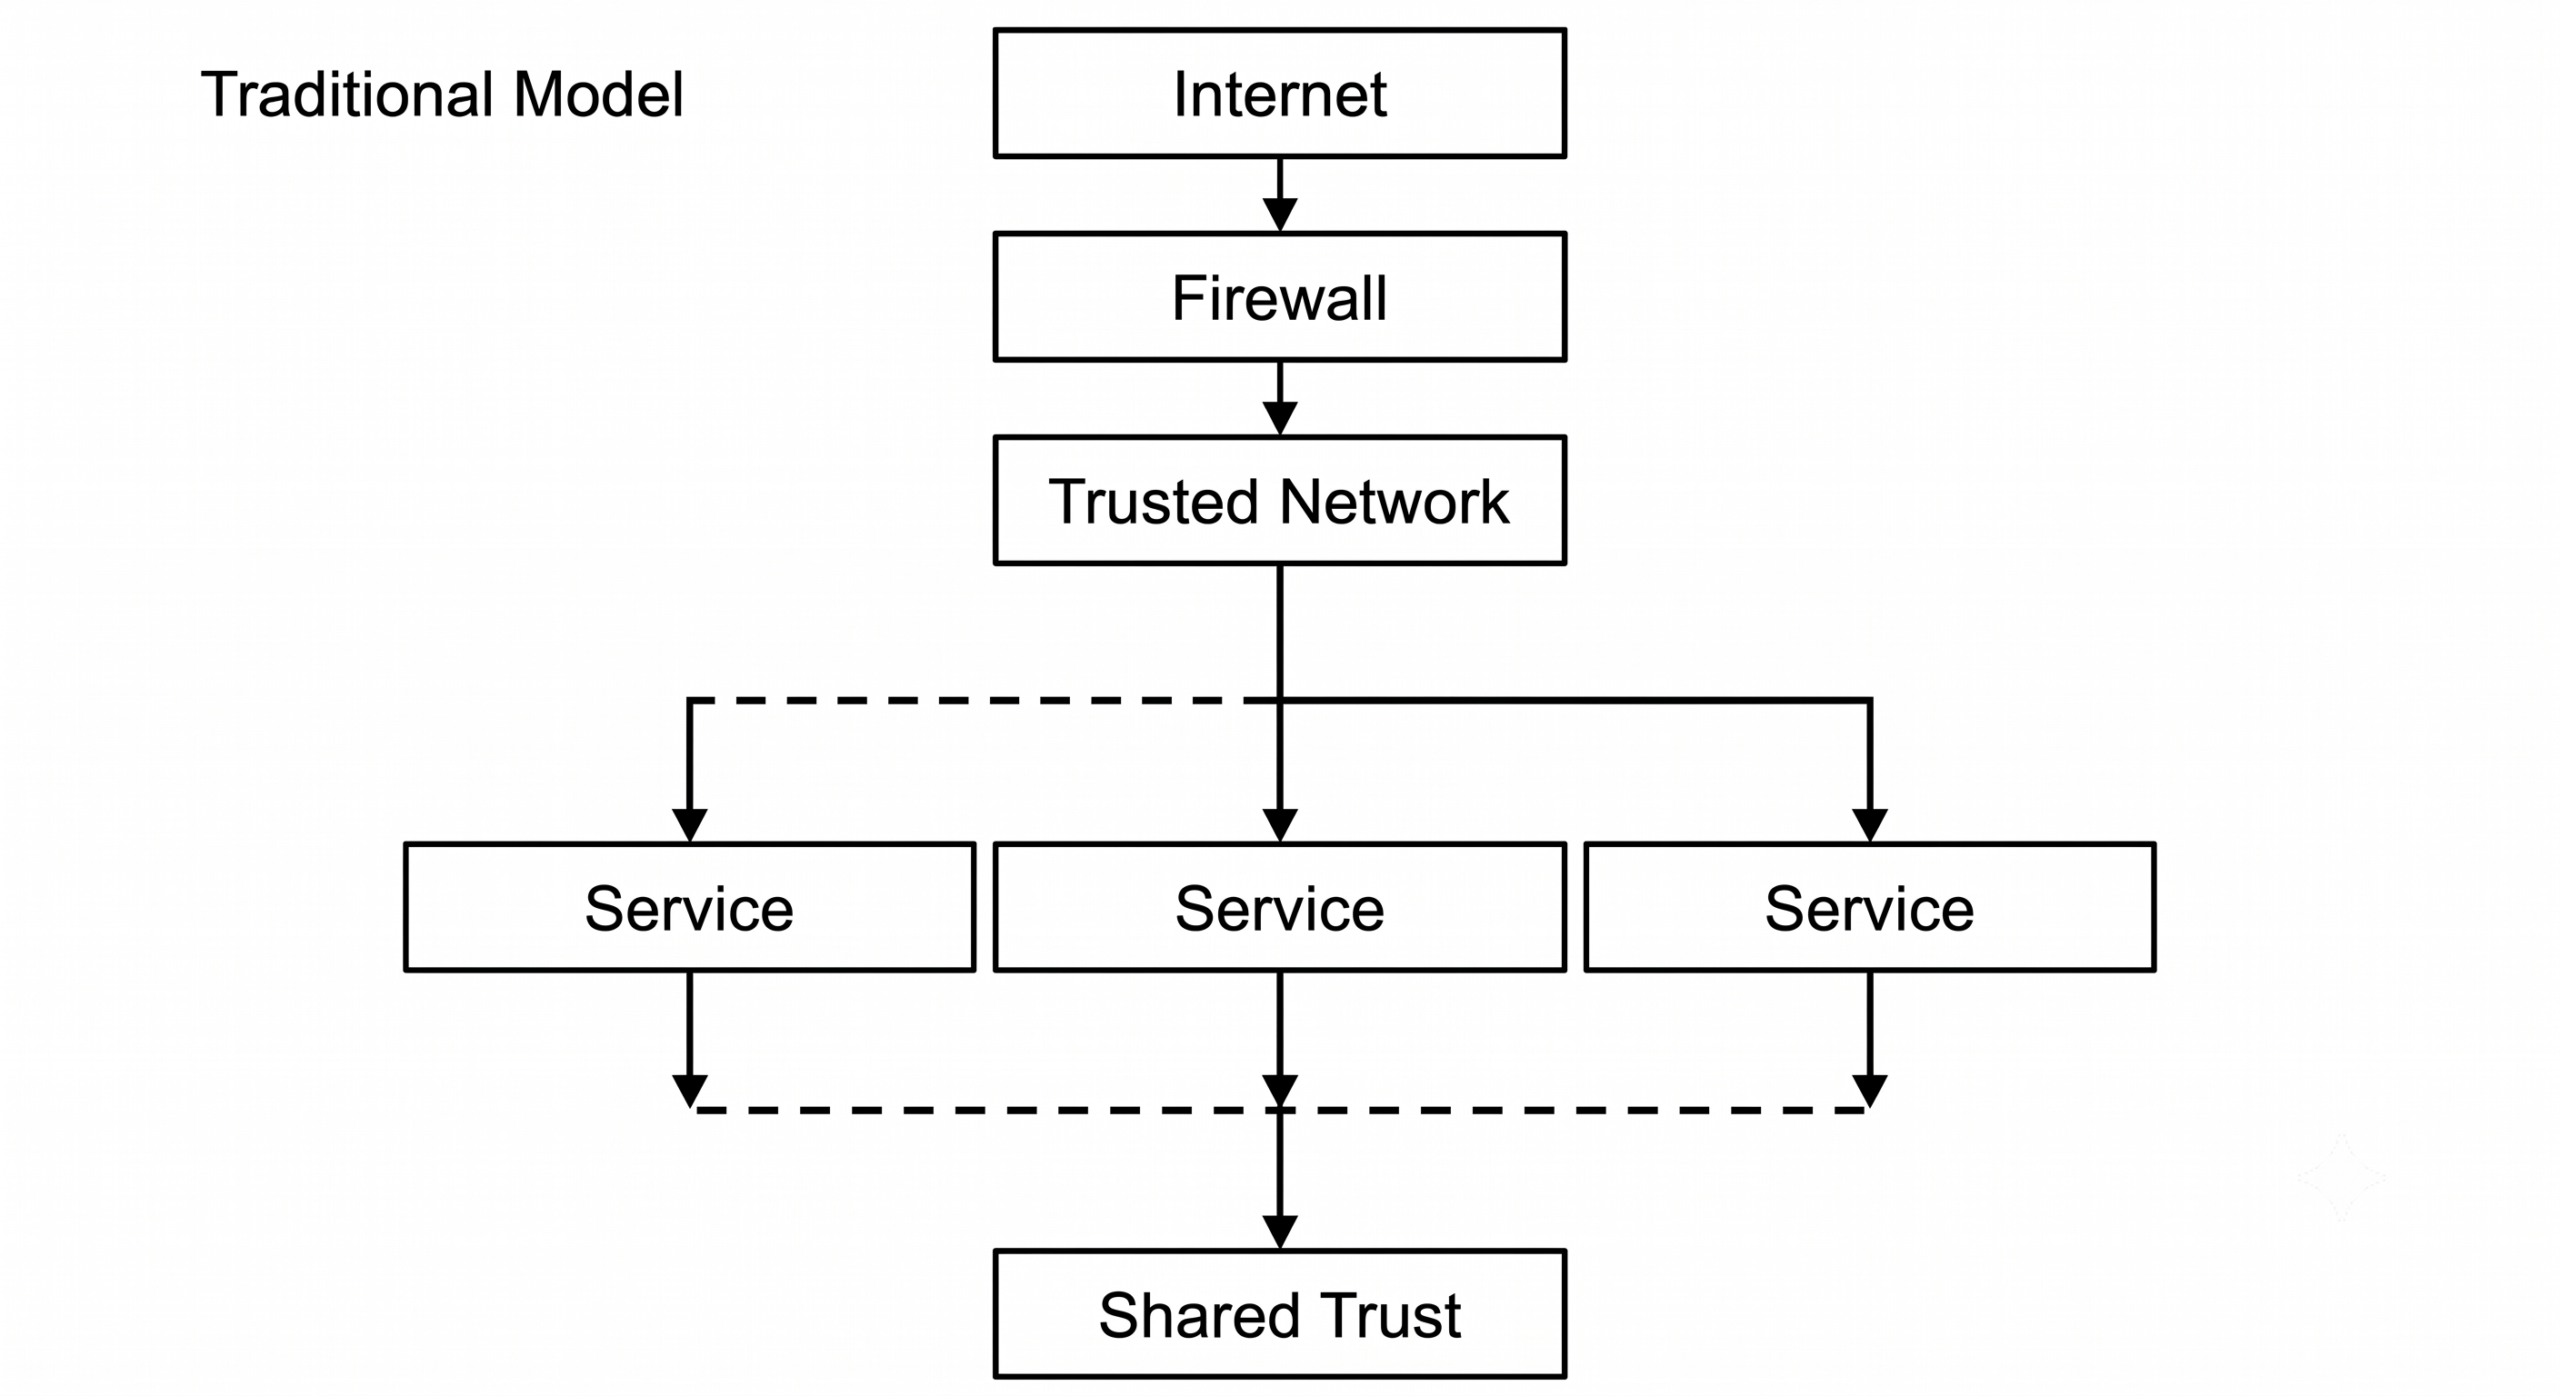
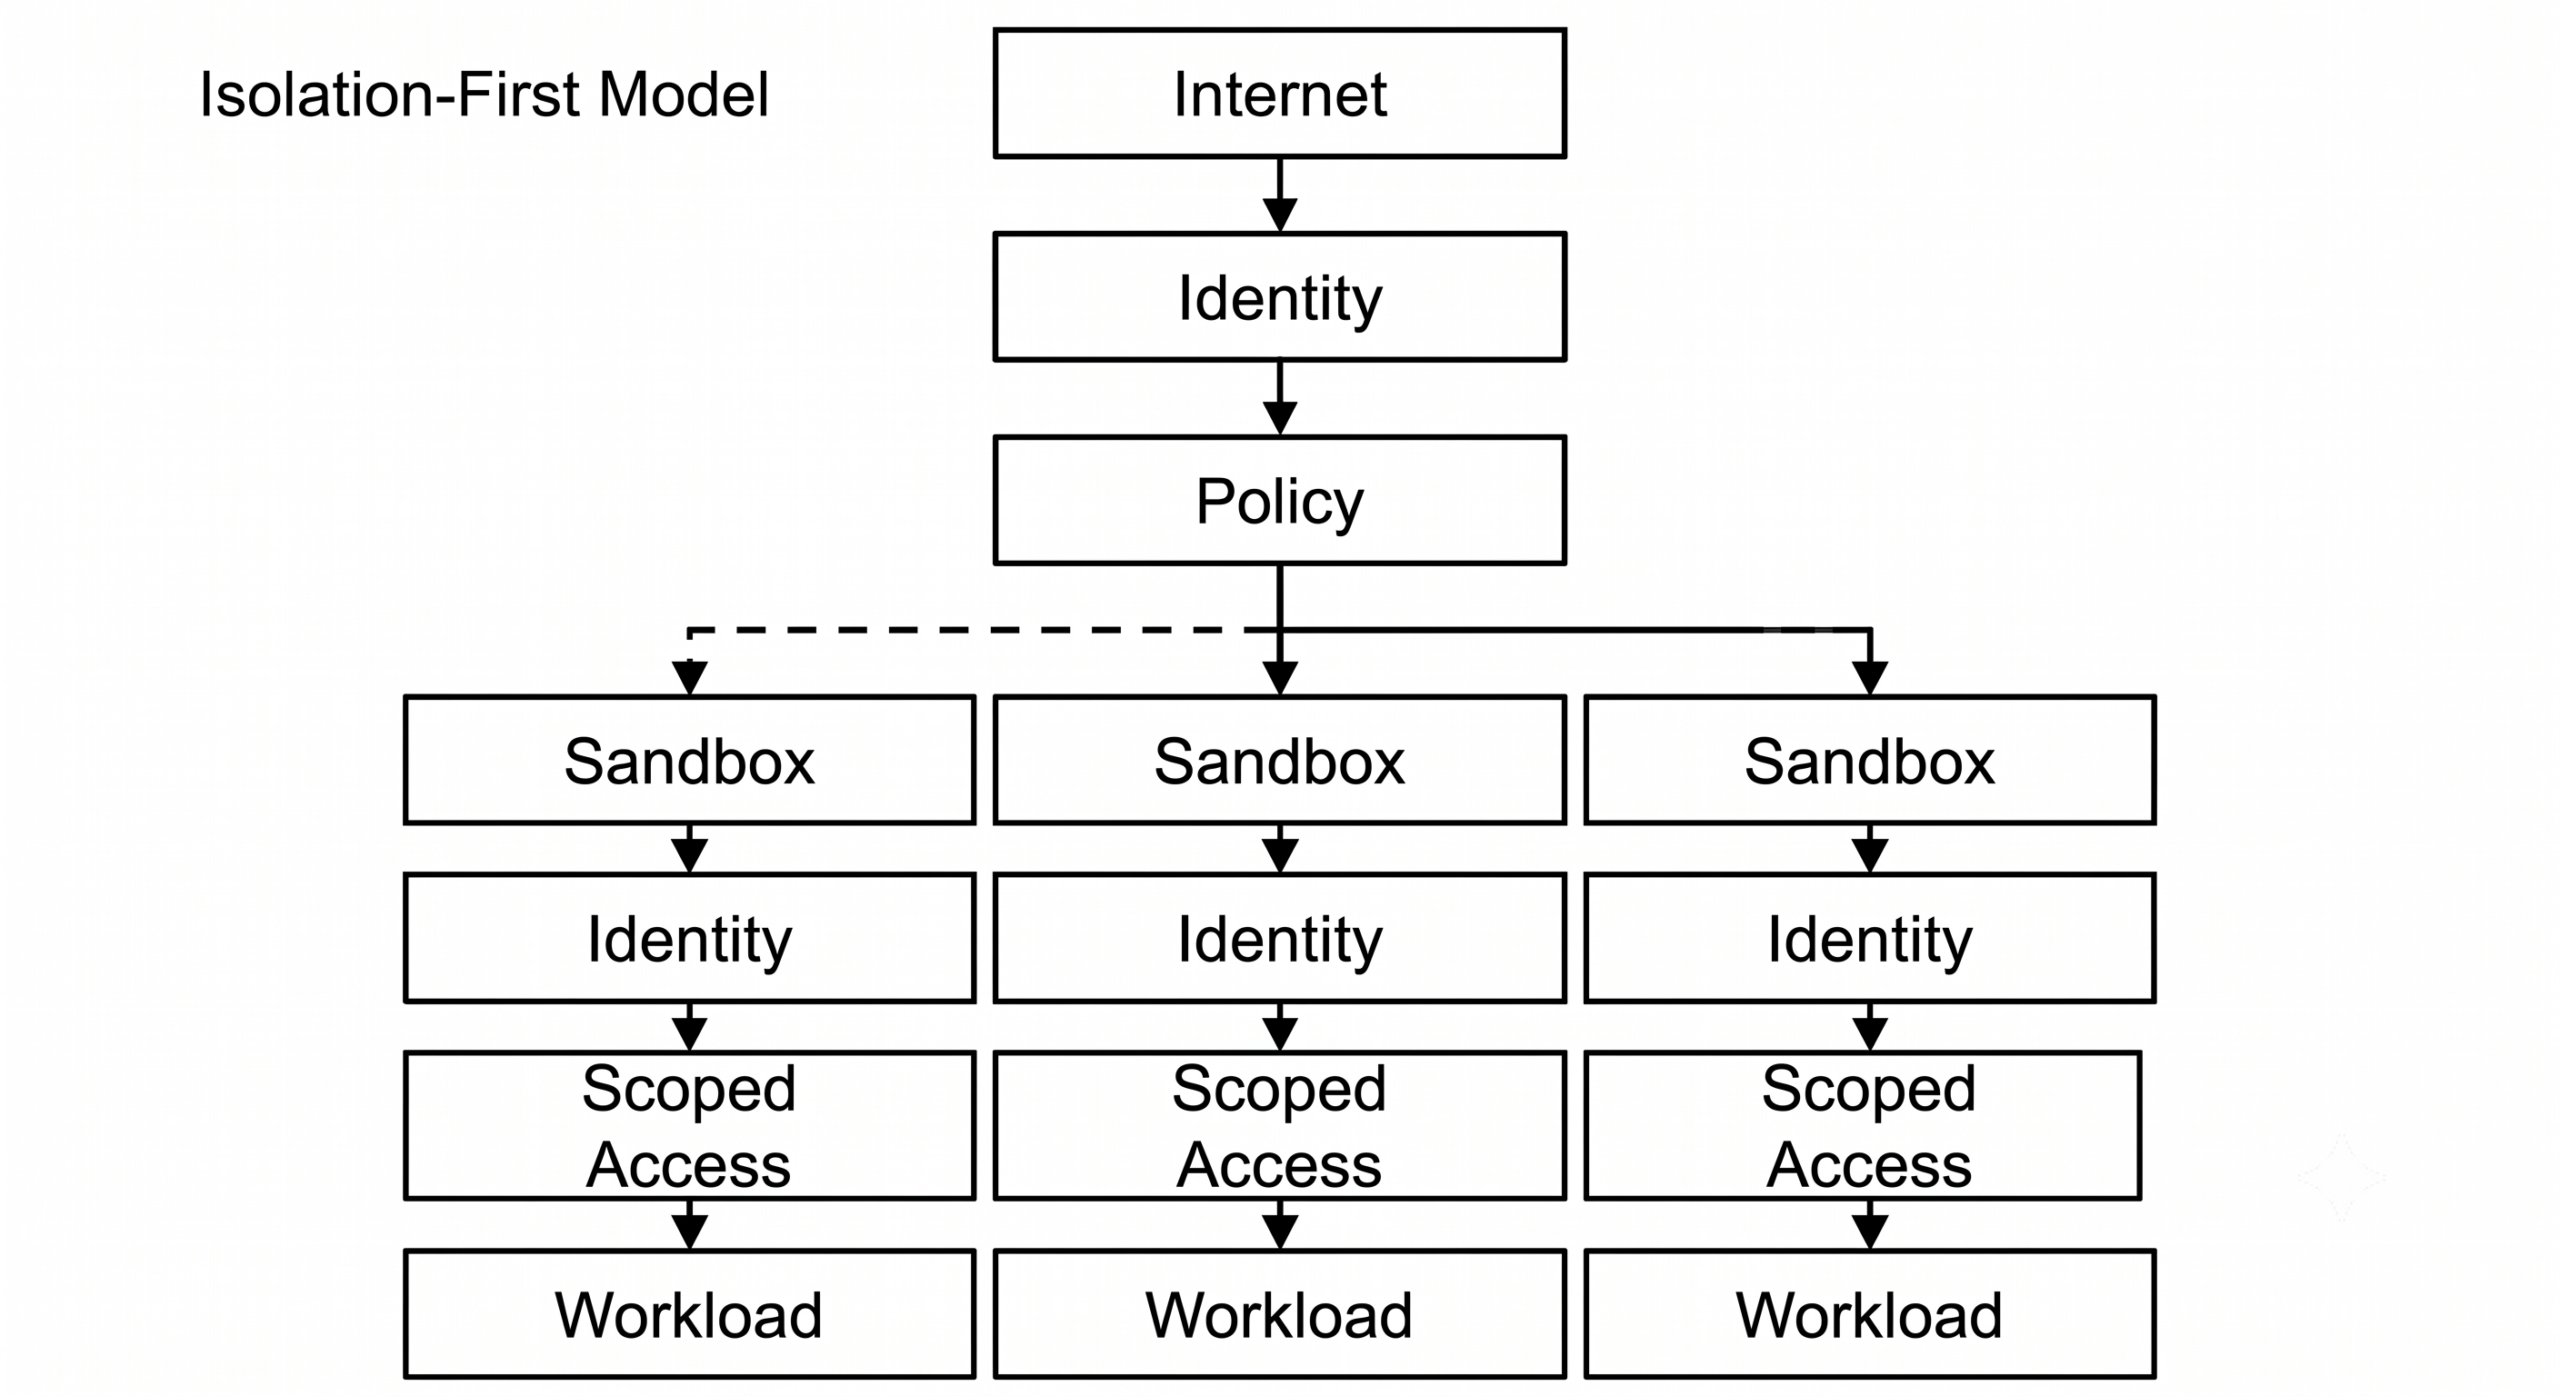
Меняется фундаментальное предположение. Вместо вопроса:
«Находится ли этот workload внутри нашей доверенной среды?»
мы задаём другой:
«Что сможет сделать этот workload, если он будет скомпрометирован?»
В этом и заключается суть isolation-first architecture.
От Isolation к Verifiable Isolation
Здесь важно различать изоляцию и проверяемую изоляцию — verifiable isolation. Заявить, что workloads изолированы, несложно. Гораздо сложнее ответить:
Как мы можем проверить, что эта граница действительно существует?
Именно поэтому становятся важными hardware roots of trust, measured boot, verified images, attestation, workload identity и policy enforcement. Архитектура постепенно должна создавать цепочку доказательств:
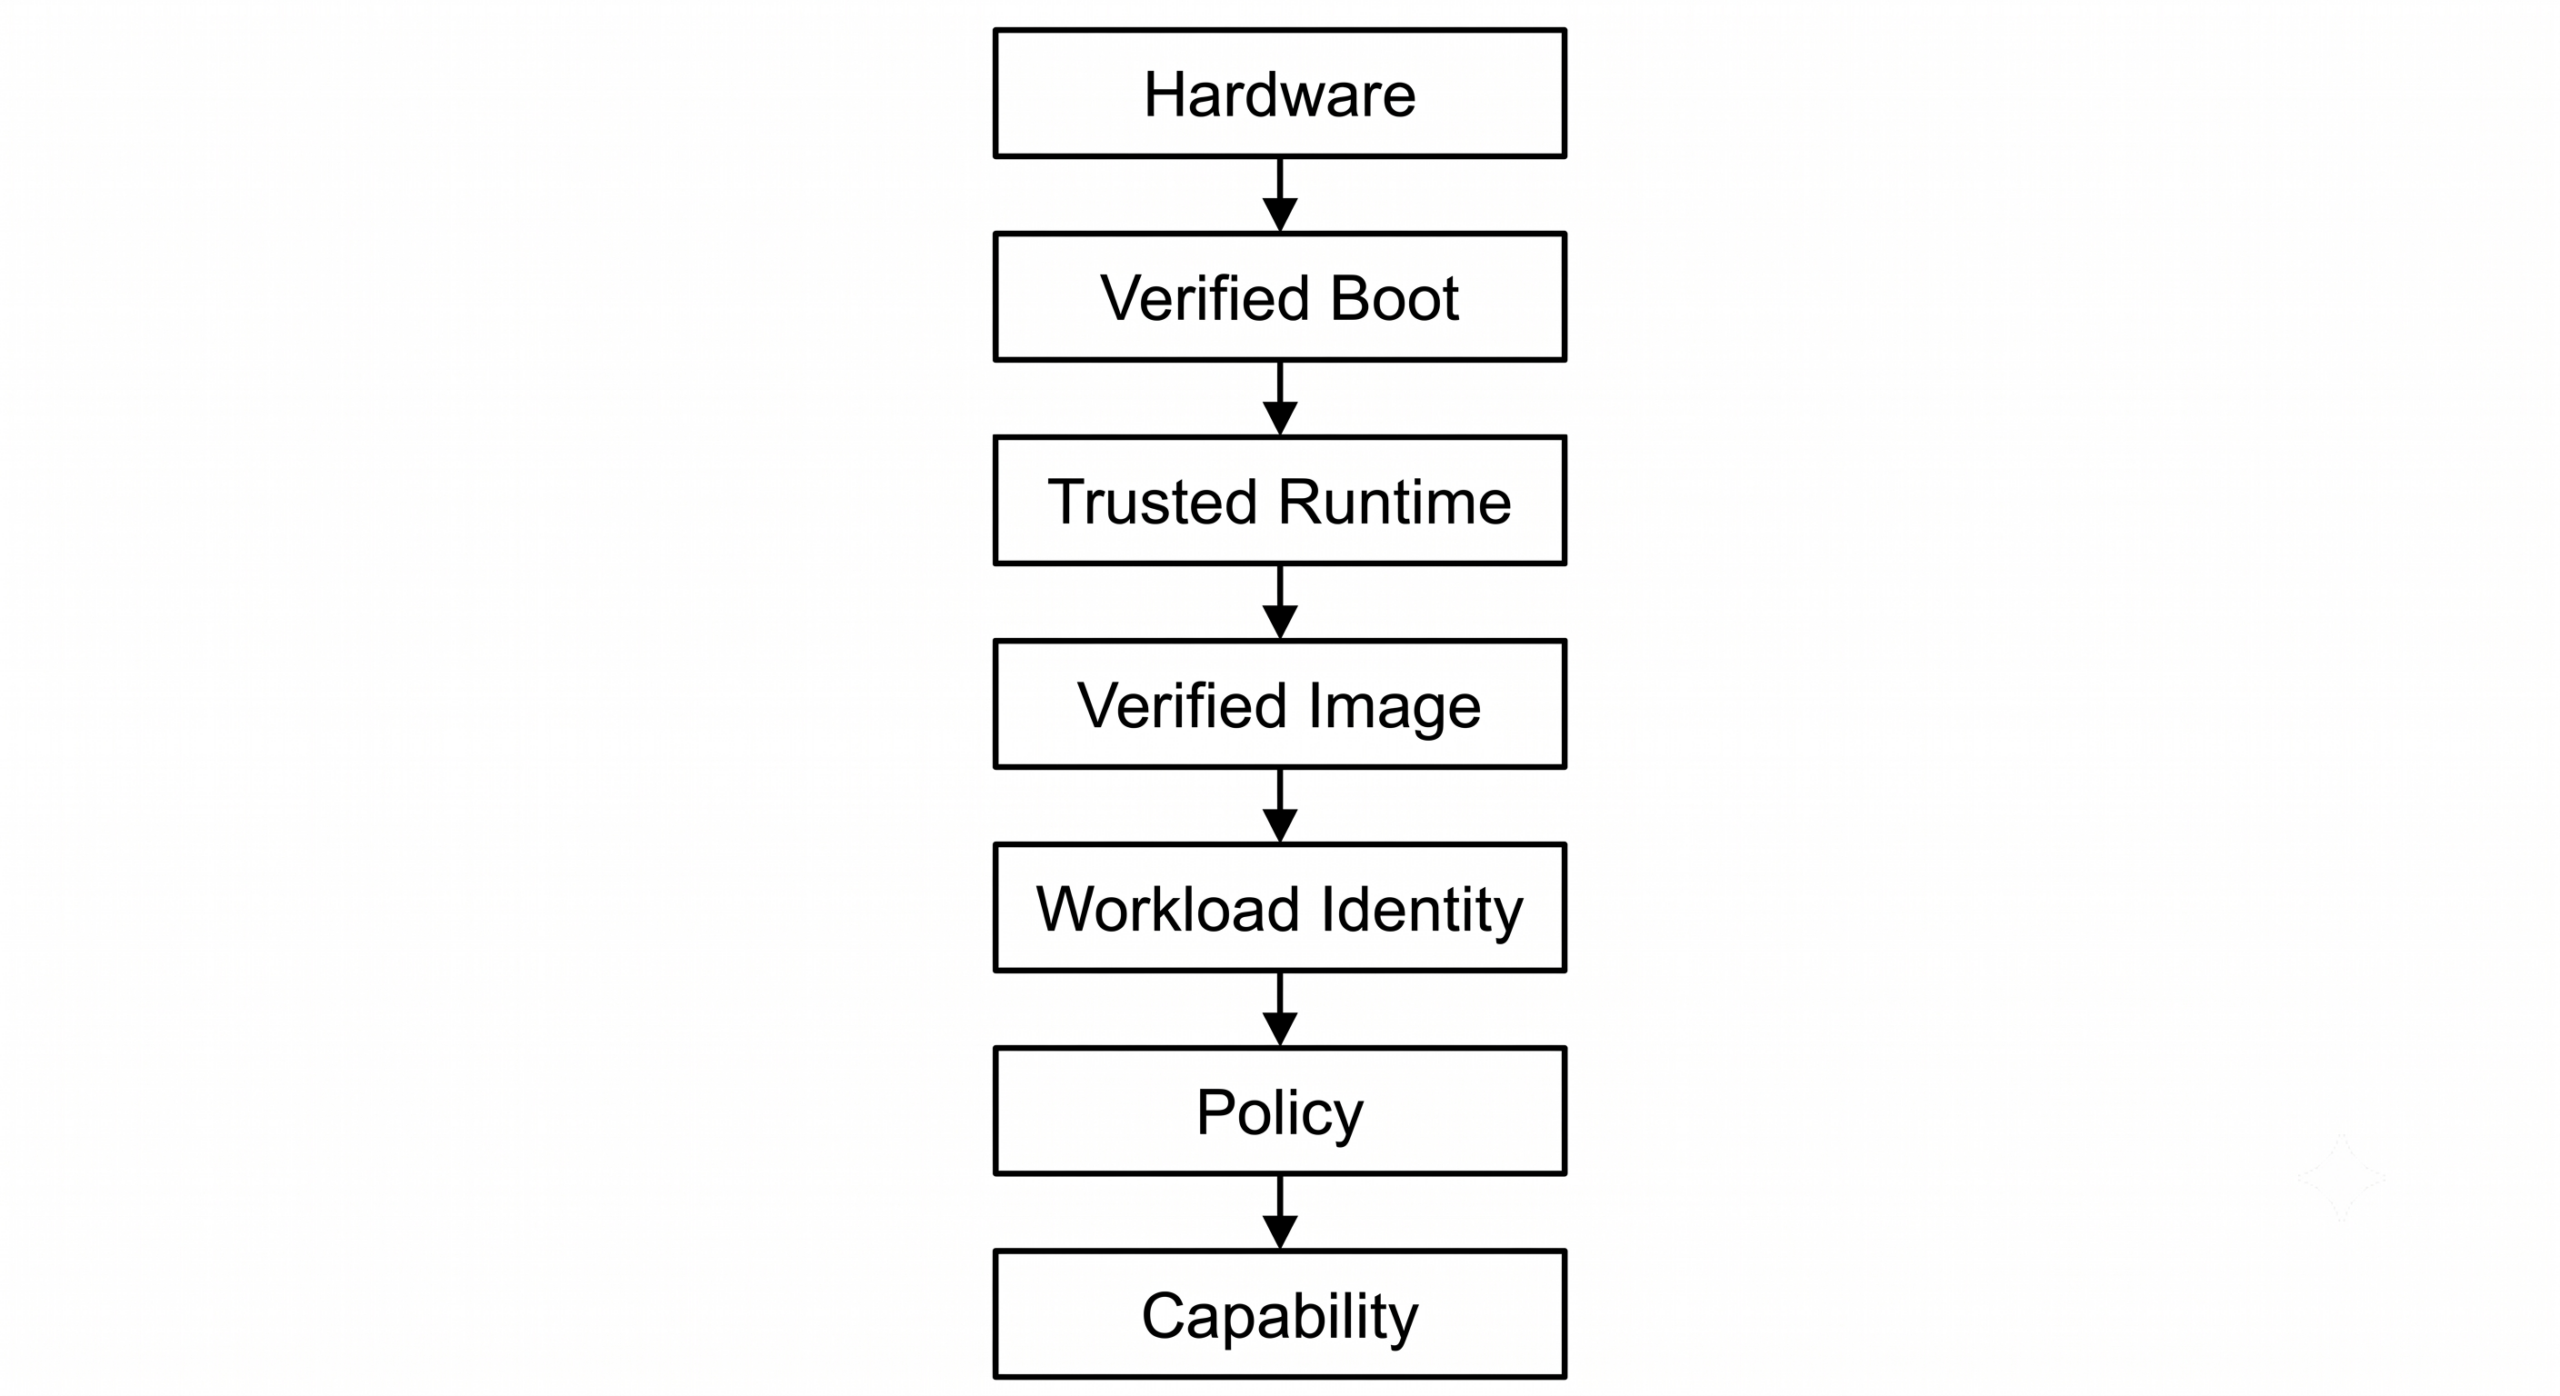
Каждый уровень предоставляет основания доверять следующему. Это принципиально отличается от ситуации, когда workload считается доверенным просто потому, что он работает в правильном кластере.
Что будет дальше?
В следующие 6–12 месяцев наиболее вероятны несколько изменений.
Высокая вероятность
Isolation всё чаще будет становиться платформенным контрактом, а не отдельной настройкой приложения.
Высокая вероятность
AI- и agent workloads будут получать более сильное sandboxing и более узко ограниченные credentials, чем обычные сервисы.
Высокая вероятность
Workload identity, short-lived credentials и policy-as-code будут всё теснее объединяться.
Средняя вероятность
Kubernetes-платформы упростят использование sandboxed execution для workloads с повышенным уровнем риска.
Средняя вероятность
Cloud-платформы будут объединять hardware-backed isolation, attestation и workload identity в интегрированные инфраструктурные примитивы.
Гипотеза с более низкой уверенностью
Strongly isolated execution станет важным конкурентным требованием для чувствительных multi-tenant environments, особенно там, где одновременно присутствуют compliance-требования и автономные workloads. При этом стоимость isolation никуда не исчезнет.
Дополнительные VM boundaries, sandboxing, отдельные control planes, дублирование observability и более строгие security controls создают overhead. Поэтому вопрос не в том, бесплатна ли изоляция. Вопрос в другом:
Ниже ли стоимость isolation, чем ожидаемая стоимость shared failure или compromise?
Что архитекторам стоит делать уже сейчас
Переход к isolation-first architecture не требует переписывать всю платформу. Нужно определить, где shared trust больше не оправдан.
1. Составить карту blast radius
Для каждого критического компонента стоит задать вопрос:
Если этот компонент будет скомпрометирован, что ещё сможет выйти из строя?
Нужно построить карту зависимостей между:
- compute;
- networking;
- IAM;
- observability;
- storage;
- control planes;
- deployment systems.
2. Перейти от network trust к workload identity
По возможности использовать identity на уровне workload. Workload не должен получать привилегии только потому, что находится в определённой сети.
3. Использовать short-lived credentials
Не выдавать автономным workloads долгоживущие cloud credentials. Предпочтительная цепочка:
identity → policy → short-lived credential → scoped capability
4. Изолировать AI- и agent workloads
Для автономных или потенциально недоверенных workloads можно использовать:
- gVisor;
- Kata Containers;
- MicroVMs;
- Confidential Containers;
- другие hardened execution boundaries.
Конкретная технология менее важна, чем сам архитектурный принцип:
агент не должен разделять больше доверия, чем ему действительно необходимо.
5. Разделять критические failure domains
Стоит рассмотреть изоляцию:
- IAM;
- observability;
- control planes;
- deployment infrastructure;
- critical data services.
Система мониторинга не должна становиться причиной того, что production-систему невозможно диагностировать.
6. Тестировать не только доступность, но и containment
Обычное availability testing задаёт вопрос:
Восстановится ли система?
Isolation-first architecture добавляет другой:
Насколько далеко распространился отказ до начала восстановления?
Поэтому нужны специальные failure containment tests. Chaos engineering должен проверять не только availability, но и:
- blast radius;
- privilege boundaries;
- credential leakage;
- tenant isolation;
- control-plane independence;
- recovery-domain boundaries.
Главный вывод
Облачная архитектура много лет оптимизировалась вокруг sharing. Shared kernels, shared clusters, shared control planes, shared observability и multi-tenant infrastructure сделали современные cloud platforms экономически жизнеспособными. Но sharing создаёт связанность. А связанность создаёт blast radius.
AI добавляет ещё одну проблему: автономные workloads способны обнаруживать, комбинировать и выполнять действия со скоростью и масштабом, к которым традиционные security assumptions не были готовы. Ответом не станет полный отказ от cloud efficiency.
Скорее речь идёт о том, чтобы гораздо более тщательно выбирать, какие компоненты действительно могут разделять один trust boundary. Архитектурную эволюцию можно представить так:
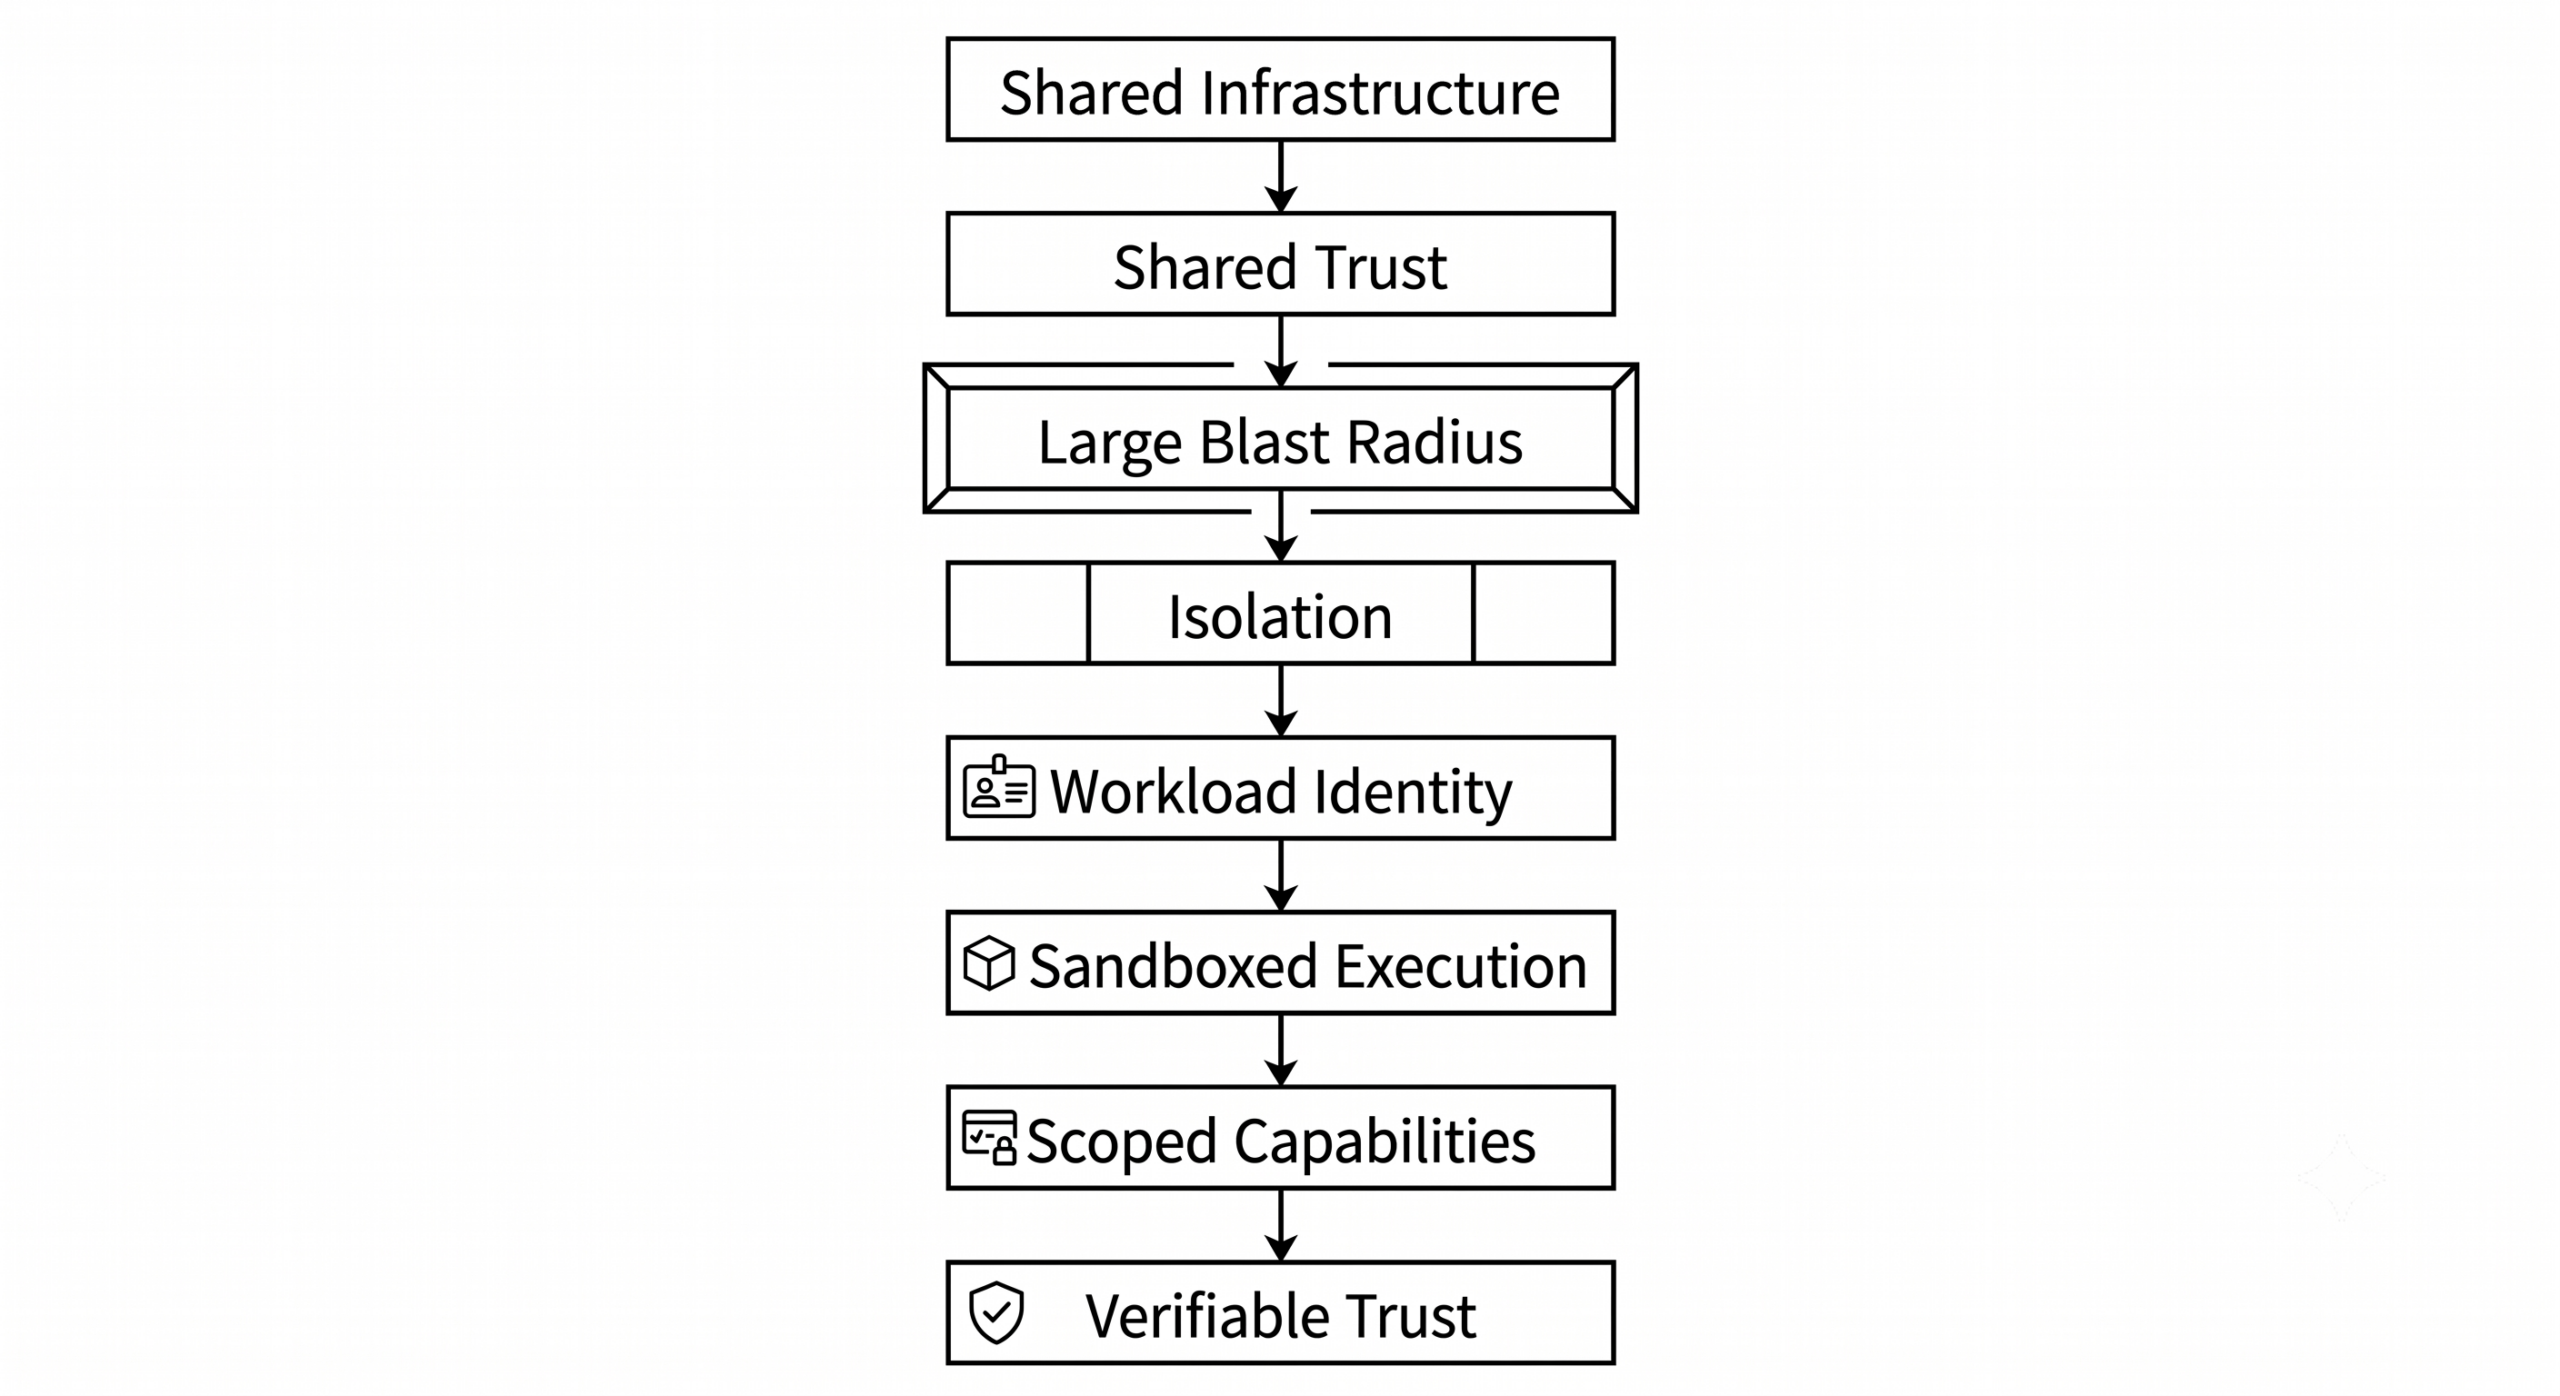
Следующий этап развития cloud architecture, вероятно, будет определяться не полной изоляцией. Он будет определяться проверяемыми границами доверия. Вопрос теперь звучит не просто:
«Насколько эффективно мы можем разделять инфраструктуру?»
А:
«Какие границы мы можем безопасно разделять — и можем ли мы доказать, что остальные границы действительно способны локализовать отказ?»
Именно этот переход — от Shared Kernel к Verifiable Isolation — может стать одним из определяющих архитектурных паттернов agentic cloud era.